
In questo articolo
Cosa saprai fare
- Spiegare assegnazione e aggiornamento in K-Means
- Impostare un rilevatore di anomalie
- Capire cosa conserva la PCA
Prima di iniziare
- Distanza euclidea, media e varianza
- NumPy e visualizzazione dei dati
In breve
- L'apprendimento non supervisionato estrae geometrie, cluster e distribuzioni latenti da dati totalmente privi di etichette target.
- K-Means minimizza la funzione di distorsione globale alternando l'assegnazione dei punti e il riposizionamento dei centroidi.
- L'Anomaly Detection modella la densità di probabilità gaussiana del funzionamento nominale, segnalando eventi con p(x) < epsilon.
- La Principal Component Analysis (PCA) proietta dati ad altissima dimensionalità lungo gli assi ortogonali di massima varianza.
L'Universo dei Dati Senza Etichette
Nella stragrande maggioranza dei contesti reali (log di server web, telemetria di sensori IoT, flussi di rete aziendali, immagini satellitari), i dati grezzi non dispongono di etichette target \(y\). Assegnare etichette manualmente a milioni di osservazioni è costoso, lento e spesso impossibile.
L'Apprendimento Non Supervisionato (Unsupervised Learning) affronta questa sfida: anziché cercare di mappare un input verso un target prefissato, esplora lo spazio matematico dei dati per estrarne cluster naturali, regolarità statistiche, componenti informative dominanti o anomalie critiche.
L'Algoritmo K-Means Clustering
Il problema del clustering consiste nel partizionare un insieme di \(m\) osservazioni non etichettate in \(K\) gruppi omogenei distinti.
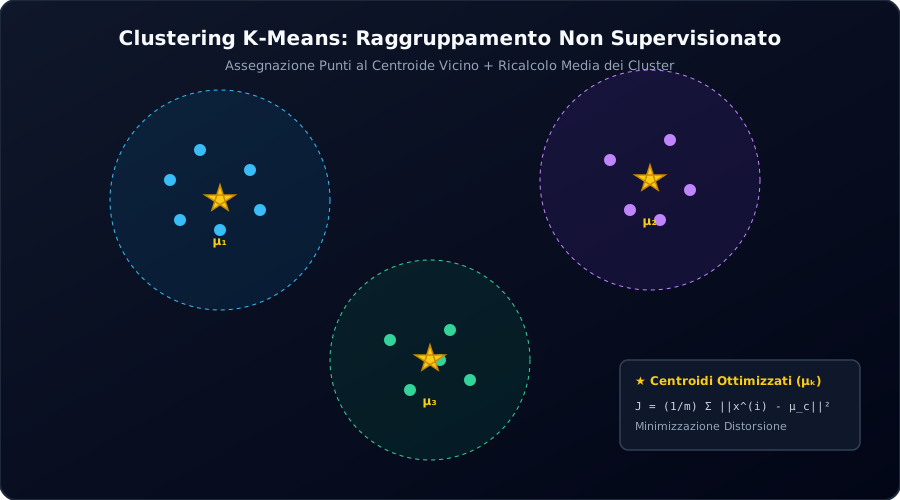
I Due Passi Fondamentali
-
Passo di Assegnazione dei Cluster: Ogni campione \(\mathbf{x}^{(i)}\) viene assegnato all'indice \(c^{(i)}\) del centroide più vicino in base alla distanza euclidea quadratica: \[c^{(i)} := \arg\min_k ||\mathbf{x}^{(i)} - \boldsymbol{\mu}_k||^2\]
-
Passo di Aggiornamento dei Centroidi: Ciascun centroide \(\boldsymbol{\mu}_k\) viene ricalcolato come media aritmetica di tutte le osservazioni assegnate a quel cluster: \[\boldsymbol{\mu}_k := \frac{1}{|C_k|} \sum_{i \in C_k} \mathbf{x}^{(i)}\]
Funzione Obiettivo di Distorsione (Inerzia)
Ad ogni singola iterazione, l'algoritmo minimizza rigorosamente la funzione di Distorsione \(J\):
\[J(c^{(1)}, \dots, c^{(m)}, \boldsymbol{\mu}_1, \dots, \boldsymbol{\mu}_K) = \frac{1}{m} \sum_{i=1}^{m} ||\mathbf{x}^{(i)} - \boldsymbol{\mu}_{c^{(i)}}||^2\]
Poiché \(J\) diminuisce (o rimane costante) a ogni passaggio e il numero di partizioni possibili è finito, l'algoritmo garantisce sempre la convergenza numerica a un minimo locale (ottimizzato tramite inizializzazione multipla casuale o K-Means++).
Rilevamento delle Anomalie con Modelli Gaussiani
Come possiamo identificare in tempo reale un attacco informatico mai visto prima o un guasto imminente su una turbina termoelettrica?
Un classificatore può generalizzare anche a esempi nuovi, ma spesso fatica se mancano anomalie rappresentative. Qui studiamo un modello di Anomaly Detection che stima la densità dei dati normali: una densità bassa segnala una deviazione, non dimostra da sola un attacco.
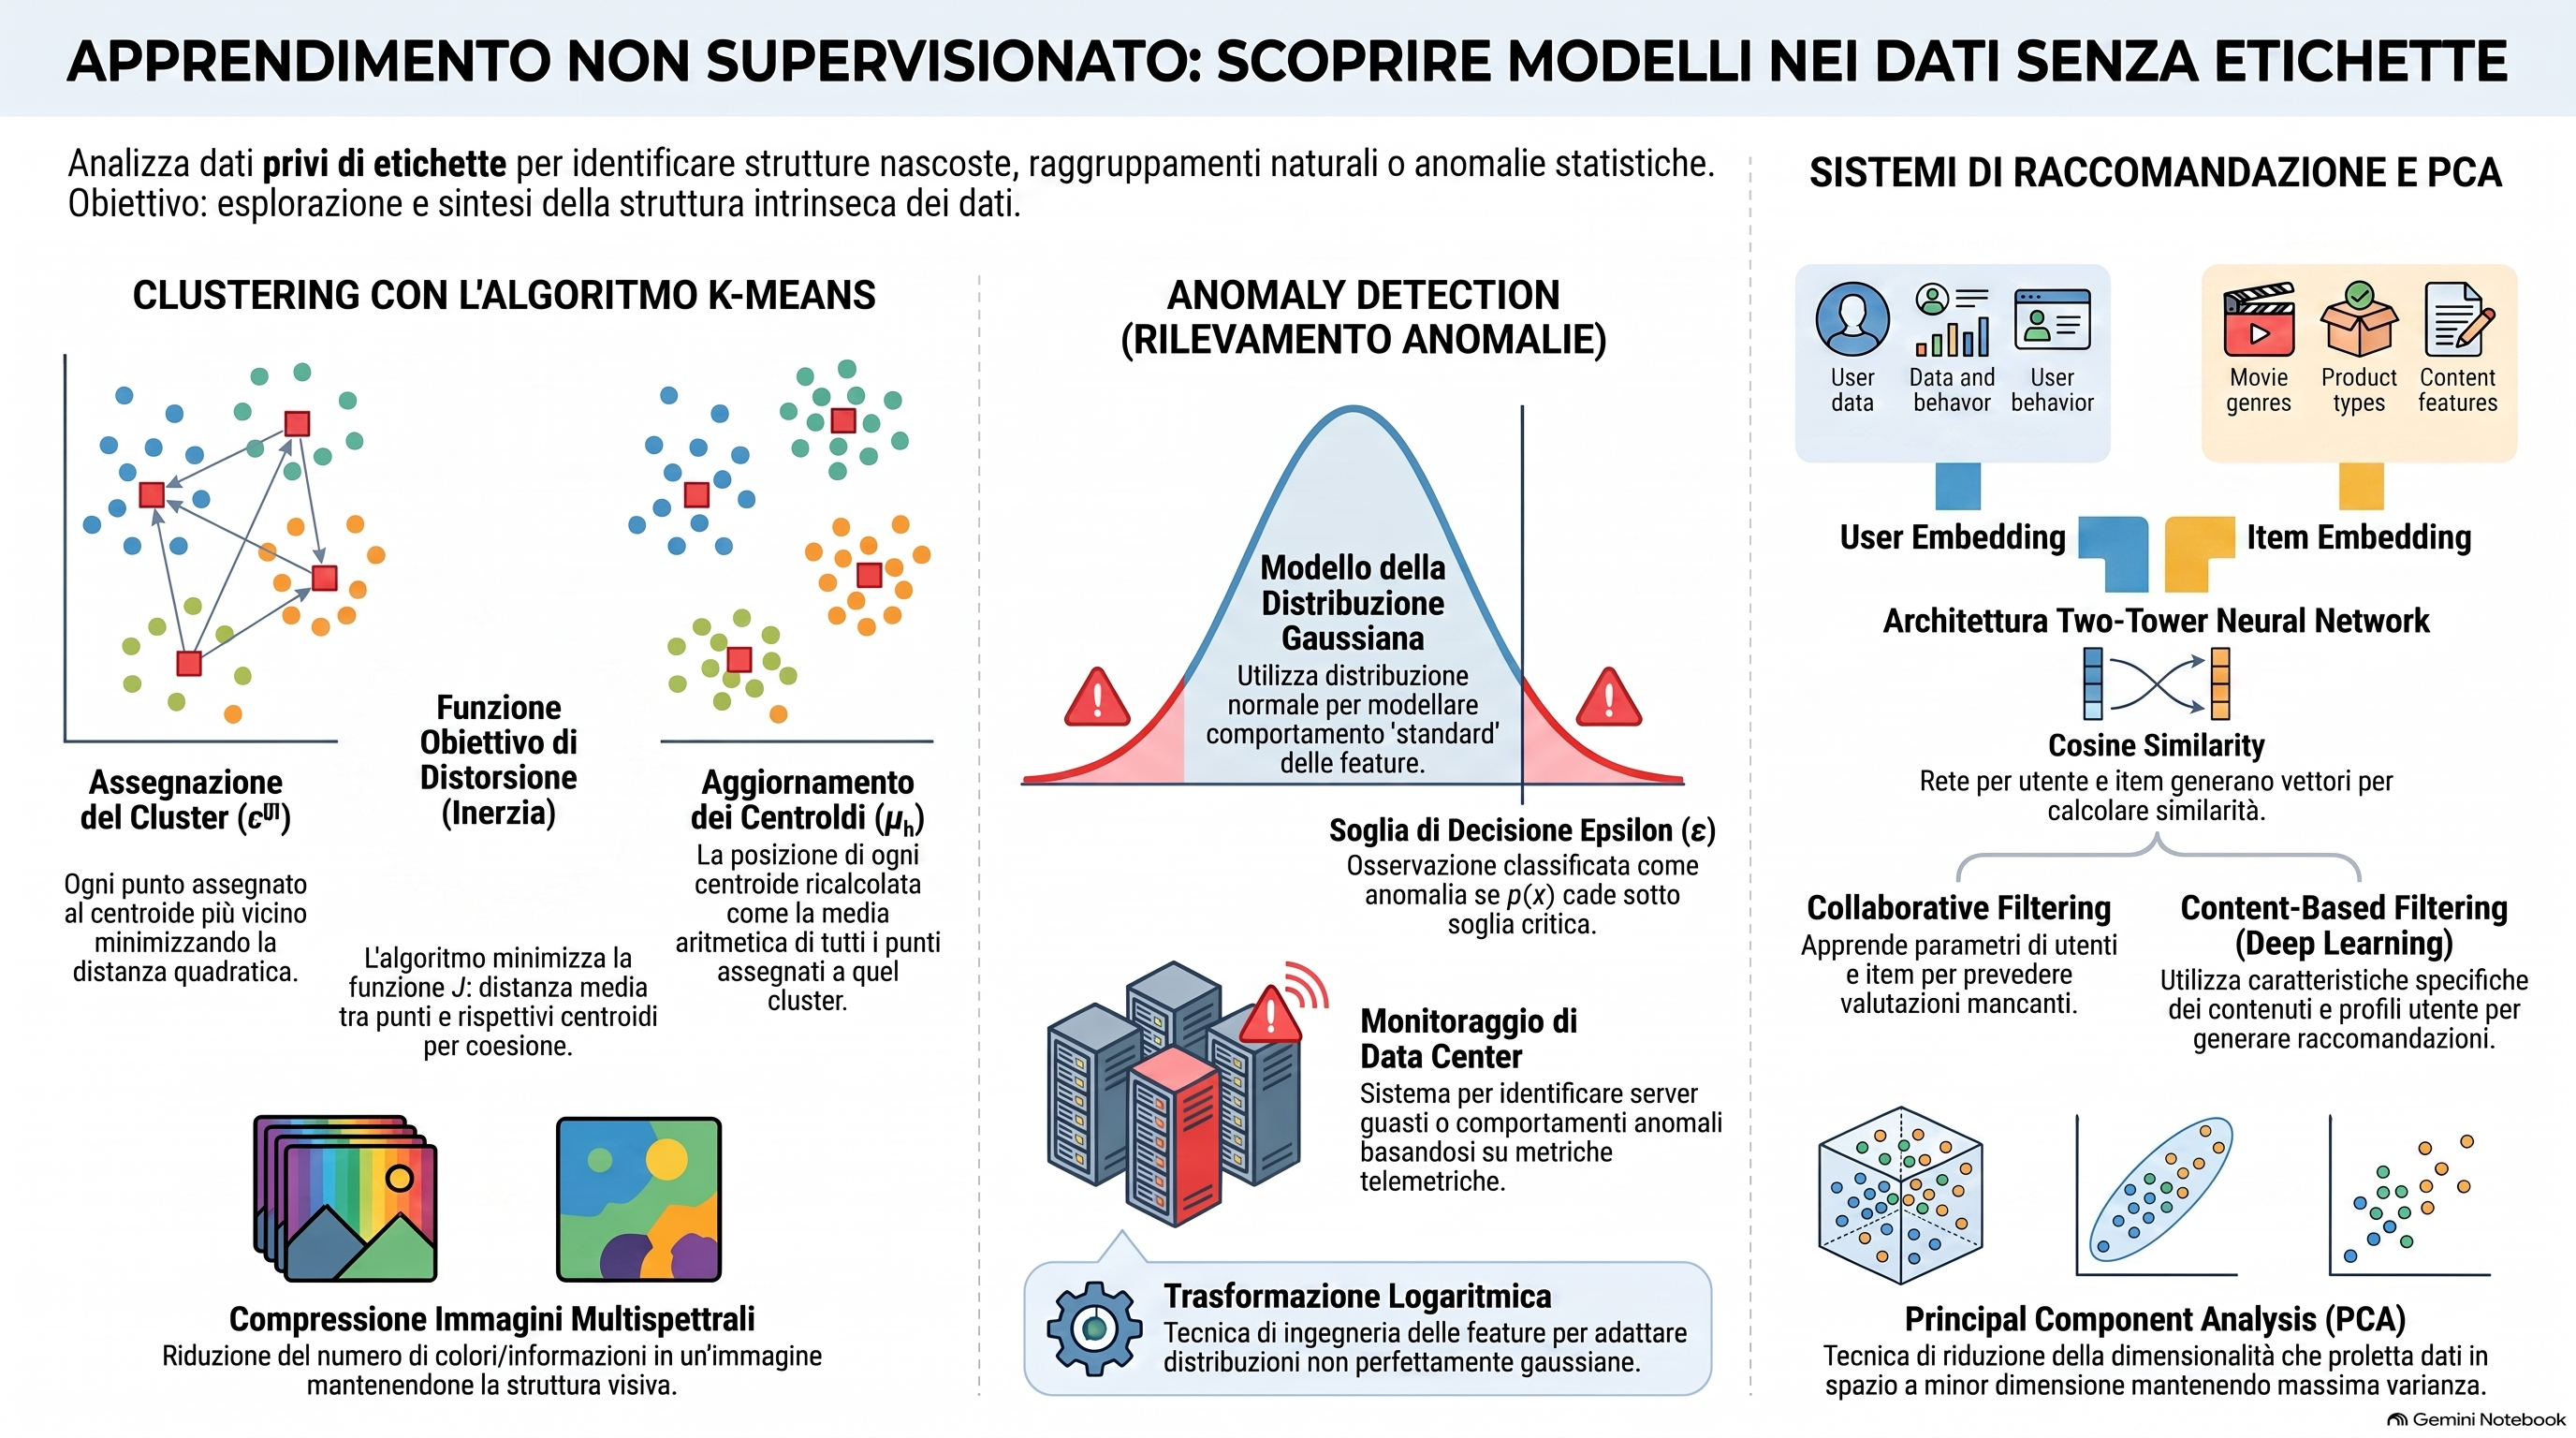
Modellazione con Distribuzione Gaussiana Multivariata
Per ciascuna delle \(n\) feature telemetriche, stimiamo la media \(\mu_j\) e la varianza \(\sigma_j^2\) sul dataset nominale non contaminato:
\[\mu_j = \frac{1}{m} \sum_{i=1}^m x_j^{(i)}, \quad \sigma_j^2 = \frac{1}{m} \sum_{i=1}^m (x_j^{(i)} - \mu_j)^2\]
Assumendo indipendenza tra le feature, la densità congiunta del modello normale è il prodotto delle singole densità gaussiane. È una gaussiana a covarianza diagonale, non la probabilità che il campione sia lecito:
\[p(\mathbf{x}) = \prod_{j=1}^n p(x_j; \mu_j, \sigma_j^2) = \prod_{j=1}^n \frac{1}{\sqrt{2\pi}\sigma_j} \exp\left( -\frac{(x_j - \mu_j)^2}{2\sigma_j^2} \right)\]
Regola di Decisione e Soglia Critica \(\epsilon\)
\[\text{Stato del Sistema} = \begin{cases} \text{ANOMALIA / ALLARME} & \text{se } p(\mathbf{x}) < \epsilon \\ \text{FUNZIONAMENTO NORMALE} & \text{se } p(\mathbf{x}) \ge \epsilon \end{cases}\]
La soglia \(\epsilon\) viene calibrata su un set di convalida incrociata (contenente un piccolo numero di anomalie note) massimizzando l'indice \(F_1\)-Score.
PCA: Principal Component Analysis (Riduzione della Dimensionalità)
Quando un dataset contiene centinaia di feature fortemente correlate tra loro, la PCA consente di proiettare i dati in uno spazio a dimensionalità ridotta \(k \ll n\) minimizzando l'errore di ricostruzione quadratico tra le proiezioni lineari della stessa dimensione.
Il Principio della Massima Varianza
- Preparazione: Si centrano le feature. La scalatura a varianza unitaria è una scelta utile quando unità e scale differiscono, non un requisito universale della PCA.
- Matrice di Covarianza: Si calcola la matrice \(\Sigma = \frac{1}{m} X^T X \in \mathbb{R}^{n \times n}\).
- Decomposizione: Si calcolano autovettori e autovalori di \(\Sigma\), oppure si applica la SVD direttamente alla matrice dei dati centrati. Gli autovettori \(u_1, u_2, \dots, u_k\) rappresentano le direzioni ortogonali lungo cui la dispersione dei dati (varianza) è massima.
- Proiezione: Il nuovo vettore compresso a \(k\) dimensioni è calcolato come \(z = U_{\text{reduce}}^T x\).
Laboratorio Pratico: Compressione K-Means e Anomaly Detection in Python
import numpy as np
from sklearn.cluster import KMeans
from sklearn.decomposition import PCA

# ==========================================
# 1. K-MEANS: COMPRESSIONE DI COLORI IMMAGINE
# ==========================================
# Creazione immagine RGB sintetica 64x64 pixel
np.random.seed(42)
img_rgb = np.random.randint(0, 256, (64, 64, 3)).astype(np.float64) / 255.0
X_pixels = img_rgb.reshape(-1, 3) # 4096 pixel, 3 canali colore

# Riduzione da 16 milioni di sfumature a soli K=16 colori dominanti
K = 16
kmeans = KMeans(n_clusters=K, random_state=42, n_init=10)
kmeans.fit(X_pixels)

# Ricostruzione immagine compressa sostituendo ogni pixel col suo centroide
X_compressed = kmeans.cluster_centers_[kmeans.labels_]
img_compressed = X_compressed.reshape(64, 64, 3)
print(f"K-Means completato: Immagine compressa con {K} centroidi colore.")

# ==========================================
# 2. ANOMALY DETECTION GAUSSIANA
# ==========================================
# Dataset nominale di telemetria server (CPU usage %, Network Throughput MB/s)
X_nominal = np.random.normal(loc=[40.0, 500.0], scale=[5.0, 50.0], size=(300, 2))

# Stima dei parametri gaussiani
mu = np.mean(X_nominal, axis=0)
sigma2 = np.var(X_nominal, axis=0)

def estimate_gaussian_prob(X, mu, sigma2):
    p = np.prod(
        (1.0 / np.sqrt(2 * np.pi * sigma2)) * np.exp(- ((X - mu)**2) / (2 * sigma2)),
        axis=1
    )
    return p

# Test su nuovo campione: [CPU=95%, Throughput=50 MB/s] (potenziale cyber-attacco)
new_sample = np.array([[95.0, 50.0], [42.0, 490.0]])
probabilities = estimate_gaussian_prob(new_sample, mu, sigma2)
epsilon = 1e-5

for idx, p in enumerate(probabilities):
    is_anomaly = p < epsilon
    print(f"Campione {idx+1}: p(x) = {p:.2e} -> {'ALLARME ANOMALIA!' if is_anomaly else 'Comportamento Nominale'}")

# ==========================================
# 3. RIDUZIONE DIMENSIONALE CON PCA
# ==========================================
pca = PCA(n_components=1)
X_pca = pca.fit_transform(X_nominal)
print(f"PCA Varianza Spiegata prima componente: {pca.explained_variance_ratio_[0]*100:.2f}%")
Conclusioni
L'apprendimento non supervisionato costituisce la base della scoperta scientifica automatizzata e della cybersecurity proattiva.
La lezione successiva applica rappresentazioni latenti e similarità ai sistemi di raccomandazione, dal filtraggio collaborativo alle architetture Two-Tower.
Verifica se il concetto è passato
Perché K-Means può produrre soluzioni diverse su due esecuzioni dello stesso dataset?
Controlla la risposta
Perché dipende dai centroidi iniziali e può convergere a minimi locali diversi; K-Means++ e più inizializzazioni riducono il problema.
Domande frequenti
Come funziona l'algoritmo K-Means a due passi?
Passo 1 (Assegnazione): calcola la distanza euclidea di ogni osservazione da tutti i K centroidi e la assegna a quello più vicino. Passo 2 (Aggiornamento): sposta ciascun centroide nella posizione media aritmetica dei punti assegnati a quel cluster. I due passi si ripetono fino alla convergenza della distorsione.
Come si sceglie il numero ottimale di cluster K?
Si traccia la curva della distorsione (inerzia) al variare di K e si cerca il punto di 'gomito' (Elbow Method), dove il tasso di diminuzione dell'errore rallenta bruscamente. In alternativa si usano criteri di business o l'indice di Silhouette.
Quando conviene usare l'Anomaly Detection invece della classificazione supervisionata?
Quando disponi di molti esempi normali e poche anomalie rappresentative, un rilevatore di deviazioni può essere utile. Non esiste una soglia universale di esempi: confronta i metodi su dati separati e misura anche i falsi allarmi. Un attacco nuovo non è necessariamente anomalo per le feature scelte.
Perché è utile applicare la trasformazione logaritmica prima dell'Anomaly Detection?
Il modello gaussiano di questa lezione fa un'ipotesi sulla distribuzione delle feature; altri rilevatori, come Isolation Forest, no. Un logaritmo può ridurre l'asimmetria di dati positivi, ma non garantisce gaussianità o maggiore accuratezza: va validato.
Cos'è la 'Explained Variance Ratio' nella PCA?
È la frazione di varianza totale dei dati conservata da ciascuna componente principale estratta. Permette di scegliere quante componenti conservano una quota, per esempio il 95%, della varianza. Varianza e informazione utile al compito non sono equivalenti: un segnale discriminante può avere varianza bassa.
Fonti e approfondimenti
- Scikit-learn - Novelty and Outlier Detection
- Scikit-learn - PCA
- Stanford University CS229 - Unsupervised Learning, Clustering and EM
- Arthur, Vassilvitskii - k-means++: The Advantages of Careful Seeding (SODA)
- Jolliffe, Cadima - Principal component analysis: a review and recent developments
- Scikit-Learn - Clustering, Density Estimation and Decomposition
Continua da qui

Diagnostica dei Modelli di Machine Learning, Metriche e Alberi Decisionali (XGBoost)
Strategia di sviluppo ML: Train/CV/Test split, diagnosi Bias vs Varianza con Learning Curves, metriche per dati sbilanciati e Random Forest/XGBoost.

Machine Learning Supervisionato: Regressione Lineare e Discesa del Gradiente
Formulazione matematica della regressione univariata e multivariata, funzione di costo MSE, discesa del gradiente e ottimizzazione vettorizzata con NumPy.

Regressione Logistica: Classificazione Binaria, Confini Decisionali e Regolarizzazione L2
Guida alla classificazione: funzione sigmoide, confini decisionali lineari e non lineari, Binary Cross-Entropy e regolarizzazione L2 Ridge.