
In questo articolo
Cosa saprai fare
- Trasformare un punteggio lineare in probabilità con la sigmoide
- Interpretare soglia e confine decisionale
- Usare BCE e regolarizzazione L2
Prima di iniziare
- Lezione 2: costo e gradiente
- Probabilità elementare
In breve
- La regressione logistica risolve problemi di classificazione incapsulando la combinazione lineare nella funzione Sigmoide.
- L'output è una stima di P(y=1|x) compresa tra 0 e 1; la calibrazione va verificata su dati separati, non è garantita dalla sigmoide.
- La funzione di costo MSE genera superfici non convesse: si adotta quindi la Binary Cross-Entropy Loss.
- La regolarizzazione L2 (Ridge) contrasta l'overfitting applicando una contrazione automatica dei pesi (Weight Decay).
Dai Problemi di Regressione alla Classificazione
In molte applicazioni ingegneristiche e di sicurezza informatica, il valore da prevedere non è continuo, ma discreto e categorico:
- Un pacchetto di rete è traffico legittimo (\(y=0\)) o un tentativo di exploit/intrusione (\(y=1\))?
- Un microchip in fase di test supera il collaudo di qualità (\(y=1\)) o è difettoso (\(y=0\))?
- Una transazione finanziaria è regolare (\(y=0\)) o fraudolenta (\(y=1\))?
Se proviamo ad applicare la regressione lineare convenzionale assegnando \(y \in \{0, 1\}\) e impostando una soglia a \(0.5\), incontriamo due gravi fallimenti strutturali:
- Predizioni Fuori Scala: Il modello lineare calcola valori arbitrari \(f(x) > 1\) o \(f(x) < 0\), privi di significato probabilistico.
- Sensibilità Estrema agli Outlier: L'inserimento nel dataset di un campione positivo con valore di feature molto elevato sposta la pendenza della retta, allontanando la soglia \(0.5\) e causando falsi negativi sistematici.
Il Modello di Regressione Logistica e la Funzione Sigmoide
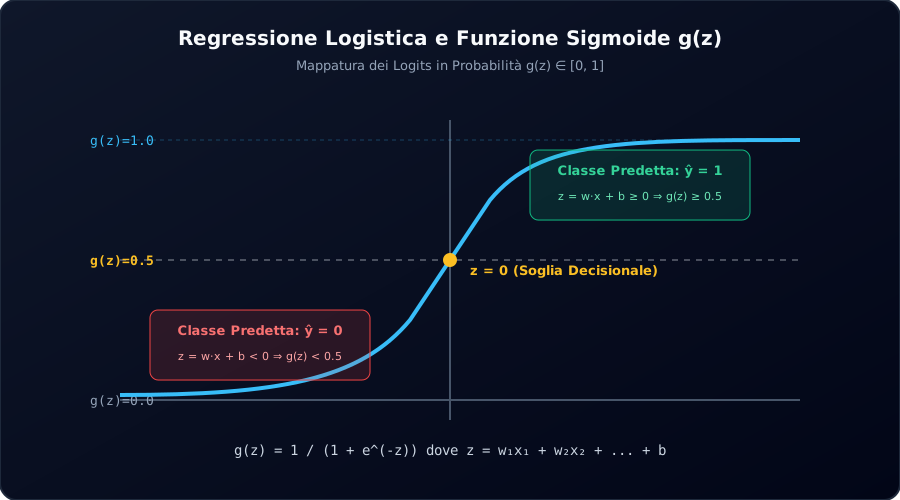
Per vincolare l'output nell'intervallo continuo \([0, 1]\), incapsuliamo la combinazione lineare \(z = \mathbf{w} \cdot \mathbf{x} + b\) all'interno della funzione Sigmoide (o logistica):
\[g(z) = \frac{1}{1 + e^{-z}}\]
L'equazione complessiva del modello di Regressione Logistica diventa:
\[f_{\mathbf{w},b}(\mathbf{x}) = g(\mathbf{w} \cdot \mathbf{x} + b) = \frac{1}{1 + e^{-(\mathbf{w} \cdot \mathbf{x} + b)}}\]
Interpretazione Probabilistica e Soglia di Decisione
L'output \(f_{\mathbf{w},b}(\mathbf{x})\) rappresenta la probabilità condizionata che l'etichetta sia \(1\) date le feature \(\mathbf{x}\): \[f_{\mathbf{w},b}(\mathbf{x}) = P(y = 1 \mid \mathbf{x}; \mathbf{w}, b)\] \[P(y = 0 \mid \mathbf{x}; \mathbf{w}, b) = 1 - f_{\mathbf{w},b}(\mathbf{x})\]
Fissando la soglia decisionale convenzionale a \(0.5\): \[\hat{y} = \begin{cases} 1 & \text{se } f_{\mathbf{w},b}(\mathbf{x}) \ge 0.5 \iff z = \mathbf{w} \cdot \mathbf{x} + b \ge 0 \\ 0 & \text{se } f_{\mathbf{w},b}(\mathbf{x}) < 0.5 \iff z = \mathbf{w} \cdot \mathbf{x} + b < 0 \end{cases}\]
Il Confine Decisionale (Decision Boundary)
Il Confine Decisionale è il luogo geometrico dei punti nello spazio delle feature in cui il modello è massimamente incerto, ovvero dove \(z = \mathbf{w} \cdot \mathbf{x} + b = 0\).
- Confine Lineare: In presenza di feature lineari di primo grado (\(w_1 x_1 + w_2 x_2 + b = 0\)), il confine è una retta o un iperpiano piano.
- Confine Non Lineare: Integrando feature polinomiali nell'argomento \(z\) (es. \(w_1 x_1^2 + w_2 x_2^2 + b = 0\)), il confine decisionale assume geometrie circolari, ellittiche o contorni ad anello complessi.
La Funzione di Costo: Binary Cross-Entropy
Se applicassimo l'errore quadratico medio (MSE) alla regressione logistica, inserendo \(g(z)\) all'interno dei quadrati, otterremmo una superficie di errore non convessa ricca di trappole e minimi locali.
Definiamo invece la Binary Cross-Entropy Loss per la singola osservazione:
\[L\left(f_{\mathbf{w},b}(\mathbf{x}), y\right) = \begin{cases} -\log\left(f_{\mathbf{w},b}(\mathbf{x})\right) & \text{se } y = 1 \\ -\log\left(1 - f_{\mathbf{w},b}(\mathbf{x})\right) & \text{se } y = 0 \end{cases}\]
Sintetizzabile in una singola espressione compatta per l'intero dataset di \(m\) campioni:
\[J(\mathbf{w}, b) = -\frac{1}{m} \sum_{i=1}^{m} \left[ y^{(i)} \log\left(f_{\mathbf{w},b}(\mathbf{x}^{(i)})\right) + (1 - y^{(i)}) \log\left(1 - f_{\mathbf{w},b}(\mathbf{x}^{(i)})\right) \right]\]
Proprietà di Penalizzazione Asintotica
- Se il target reale è \(y=1\) e il modello predice \(f \to 1\), la perdita è nulla (\(-\log(1) = 0\)). Se il modello predice erroneamente con sicurezza \(f \to 0\), la perdita tende asintoticamente a \(+\infty\).
- Per il modello lineare nelle feature qui descritto, \(J(\mathbf{w}, b)\) è convessa. Unicità e presenza di un minimo finito richiedono ulteriori condizioni: non derivano dalla sola scelta della loss.
Discesa del Gradiente e Regolarizzazione L2 (Ridge)
Calcolando le derivate parziali di \(J(\mathbf{w}, b)\) rispetto ai pesi e al bias:
\[\frac{\partial J(\mathbf{w}, b)}{\partial w_j} = \frac{1}{m} \sum_{i=1}^{m} \left( f_{\mathbf{w},b}(\mathbf{x}^{(i)}) - y^{(i)} \right) x_j^{(i)}\]
\[\frac{\partial J(\mathbf{w}, b)}{\partial b} = \frac{1}{m} \sum_{i=1}^{m} \left( f_{\mathbf{w},b}(\mathbf{x}^{(i)}) - y^{(i)} \right)\]
Notate la straordinaria eleganza algebrica: pur essendo cambiata la definizione di \(f(\mathbf{x})\), la forma matematica del gradiente è identica a quella della regressione lineare.
Regolarizzazione L2 e Weight Decay
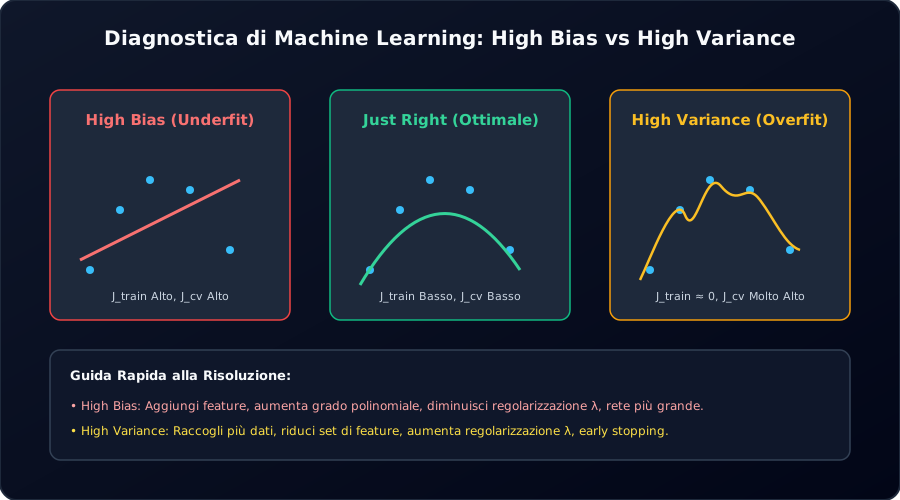
Quando si utilizzano molte feature o polinomi di grado elevato, i coefficienti \(w\) possono assumere valori giganteschi nel tentativo di memorizzare il rumore (Overfitting).
Aggiungiamo una penalità di regolarizzazione \(L_2\) proporzionale al parametro \(\lambda\):
\[J_{\text{reg}}(\mathbf{w}, b) = J(\mathbf{w}, b) + \frac{\lambda}{2m} \sum_{j=1}^{n} w_j^2\]
L'aggiornamento iterativo dei pesi incorpora il fattore di contrazione (Weight Decay):
\[w_j := w_j \left( 1 - \alpha \frac{\lambda}{m} \right) - \alpha \frac{1}{m} \sum_{i=1}^{m} \left( f_{\mathbf{w},b}(\mathbf{x}^{(i)}) - y^{(i)} \right) x_j^{(i)}\]
Laboratorio Pratico Completo in Python
Di seguito un esempio didattico from-scratch della regressione logistica regolarizzata. Il controllo finale usa gli stessi dati del training: serve a verificare l'adattamento, non a stimare prestazioni su nuovi campioni. Per farlo occorre un test set separato.
import numpy as np

# 1. Definizione della funzione Sigmoide numericamente stabile
def sigmoid(z):
    z = np.clip(z, -500, 500) # Prevenzione overflow numerico
    return 1.0 / (1.0 + np.exp(-z))

# 2. Calcolo del Costo Regolarizzato (Binary Cross-Entropy)
def compute_cost_logistic_reg(X, y, w, b, lambda_reg=1.0):
    m = X.shape[0]
    z = np.dot(X, w) + b
    f_wb = sigmoid(z)

    # Epsilon per stabilizzare il calcolo del logaritmo
    eps = 1e-15
    f_wb = np.clip(f_wb, eps, 1.0 - eps)

    loss = - (y * np.log(f_wb) + (1.0 - y) * np.log(1.0 - f_wb))
    cost = (1.0 / m) * np.sum(loss)

    reg_cost = (lambda_reg / (2.0 * m)) * np.sum(w ** 2)
    return cost + reg_cost

# 3. Calcolo del Gradiente Regolarizzato
def compute_gradient_logistic_reg(X, y, w, b, lambda_reg=1.0):
    m, n = X.shape
    f_wb = sigmoid(np.dot(X, w) + b)
    err = f_wb - y

    dj_dw = (1.0 / m) * np.dot(X.T, err) + (lambda_reg / m) * w
    dj_db = (1.0 / m) * np.sum(err)
    return dj_dw, dj_db

# 4. Addestramento con Discesa del Gradiente
def fit_logistic_regression(X, y, alpha=0.1, lambda_reg=0.1, iters=1000):
    m, n = X.shape
    w = np.zeros(n)
    b = 0.0

    for i in range(iters):
        dj_dw, dj_db = compute_gradient_logistic_reg(X, y, w, b, lambda_reg)
        w -= alpha * dj_dw
        b -= alpha * dj_db

        if i % 200 == 0:
            cost = compute_cost_logistic_reg(X, y, w, b, lambda_reg)
            print(f"Iterazione {i:4d}: Costo BCE = {cost:.4f}")

    return w, b

# 5. Esempio sintetico di training (Quality Assurance Microchip)
np.random.seed(42)
m_samples = 120
X_train_data = np.random.randn(m_samples, 2)
# Campioni con distanza dall'origine al quadrato < 1.2 sono validi (y=1)
y_train_data = ((X_train_data[:, 0]**2 + X_train_data[:, 1]**2) < 1.2).astype(float)

# Ingegneria di feature polinomiali per confine circolare: [x1, x2, x1^2, x2^2]
X_poly = np.column_stack([
    X_train_data[:, 0],
    X_train_data[:, 1],
    X_train_data[:, 0]**2,
    X_train_data[:, 1]**2
])

w_trained, b_trained = fit_logistic_regression(X_poly, y_train_data, alpha=0.5, lambda_reg=0.01, iters=1000)

# 6. Accuratezza sul training: non misura la generalizzazione
preds_prob = sigmoid(np.dot(X_poly, w_trained) + b_trained)
preds_class = (preds_prob >= 0.5).astype(float)
accuracy = np.mean(preds_class == y_train_data) * 100

print(f"\nAccuratezza sul training: {accuracy:.2f}%")
print(f"Pesi appresi: {w_trained}")
print(f"Bias appreso: {b_trained:.4f}")
Conclusioni
La regressione logistica regolarizzata introduce concetti che ritroveremo nelle reti neurali: combinazioni lineari, attivazioni, loss e gradienti. La lezione successiva mostra come questi elementi si compongono nel Deep Learning per apprendere rappresentazioni e confini decisionali più espressivi.
Verifica se il concetto è passato
Cambiare la soglia da 0,5 a 0,8 modifica i pesi appresi dal modello?
Controlla la risposta
No. Modifica la regola con cui la probabilità viene convertita in classe; i pesi cambiano solo con un nuovo addestramento.
Domande frequenti
Perché la regressione lineare non è adatta per problemi di classificazione binaria?
La regressione lineare produce valori continui illimitati (-inf, +inf) anziché probabilità [0, 1]. Inoltre, la presenza di outlier lontani dal confine decisionale sposta sensibilmente la retta di regressione, alterando drasticamente la soglia di classificazione corretta.
Cosa rappresenta la funzione Sigmoide g(z)?
La funzione Sigmoide g(z) = 1 / (1 + e^-z) mappa qualsiasi valore reale z (logit) nell'intervallo continuo tra 0 e 1, consentendo un'interpretazione probabilistica naturale della decisione.
Come si definisce geometricamente il confine decisionale (Decision Boundary)?
Il confine decisionale è l'iperpiano o la curva definita dall'equazione z = w * x + b = 0, dove la probabilità predetta è esattamente 0.5. Separa lo spazio delle feature nella regione associata alla classe 1 da quella associata alla classe 0.
La Binary Cross-Entropy garantisce sempre una soluzione ottima?
Nella regressione logistica lineare il costo è convesso, ma non sempre strettamente convesso. Senza regolarizzazione, su dati separabili il minimo può non essere raggiunto con pesi finiti. La convergenza dipende anche da learning rate e criterio di arresto; nelle reti neurali la stessa loss non rende convesso il problema.
Come agisce il termine di regolarizzazione L2 durante la discesa del gradiente?
Con la loss e la discesa del gradiente usate qui, L2 aggiunge lambda * w_j / m al gradiente. Il fattore 1 - alpha * lambda / m è una contrazione positiva solo con un passo adeguato. L'equivalenza con weight decay non si estende automaticamente agli ottimizzatori adattivi.
Fonti e approfondimenti
Continua da qui

Apprendimento Non Supervisionato: Clustering K-Means, Anomaly Detection e PCA
Estrarre pattern senza etichette: algoritmo K-Means, rilevamento delle anomalie con curve gaussiane e riduzione dimensionale PCA.

Diagnostica dei Modelli di Machine Learning, Metriche e Alberi Decisionali (XGBoost)
Strategia di sviluppo ML: Train/CV/Test split, diagnosi Bias vs Varianza con Learning Curves, metriche per dati sbilanciati e Random Forest/XGBoost.

Machine Learning Supervisionato: Regressione Lineare e Discesa del Gradiente
Formulazione matematica della regressione univariata e multivariata, funzione di costo MSE, discesa del gradiente e ottimizzazione vettorizzata con NumPy.