
In questo articolo
Cosa saprai fare
- Confrontare nove famiglie di regressori
- Partire da una baseline semplice
- Scegliere metriche e modello in base ai dati
Prima di iniziare
- Lezione 2: regressione lineare
- Concetto di train e test set
In breve
- Non esiste un singolo algoritmo di regressione universalmente superiore: ogni modello presenta specifici trade-off matematici.
- I modelli lineari e polinomiali offrono massima interpretabilità ma faticano su pattern non lineari complessi.
- Random Forest e XGBoost rappresentano la scelta di riferimento per dati tabulari strutturati ad alte prestazioni.
- SVR con kernel può funzionare bene con molte feature e un numero contenuto di esempi; sui dataset grandi il costo cresce rapidamente. Le reti neurali richiedono invece dati e risorse adeguati.
Il Falso Mito del Miglior Algoritmo Universale
Uno degli errori più diffusi tra sviluppatori e data scientist è credere che esista un singolo algoritmo di Machine Learning superiore a tutti gli altri per risolvere qualsiasi problema di regressione.
La realtà ingegneristica è regolata dal celebre teorema del No Free Lunch: ogni modello algoritmico incorpora assunzioni a priori (inductive bias), proprietà matematiche e compromessi operativi. Scegliere l'algoritmo migliore significa bilanciare:
- La natura intrinseca della relazione: Lineare, parabolica, a gradini, periodica o caotica;
- La struttura del dataset: Volume di campioni (\(m\)), numero di feature (\(n\)) e densità delle matrici;
- Requisiti di business e interpretabilità: Necessità di audit normativo dei pesi vs accuratezza pura a "scatola nera";
- Vincoli infrastrutturali: Latenza massima di inferenza, budget computazionale di training e disponibilità di GPU.
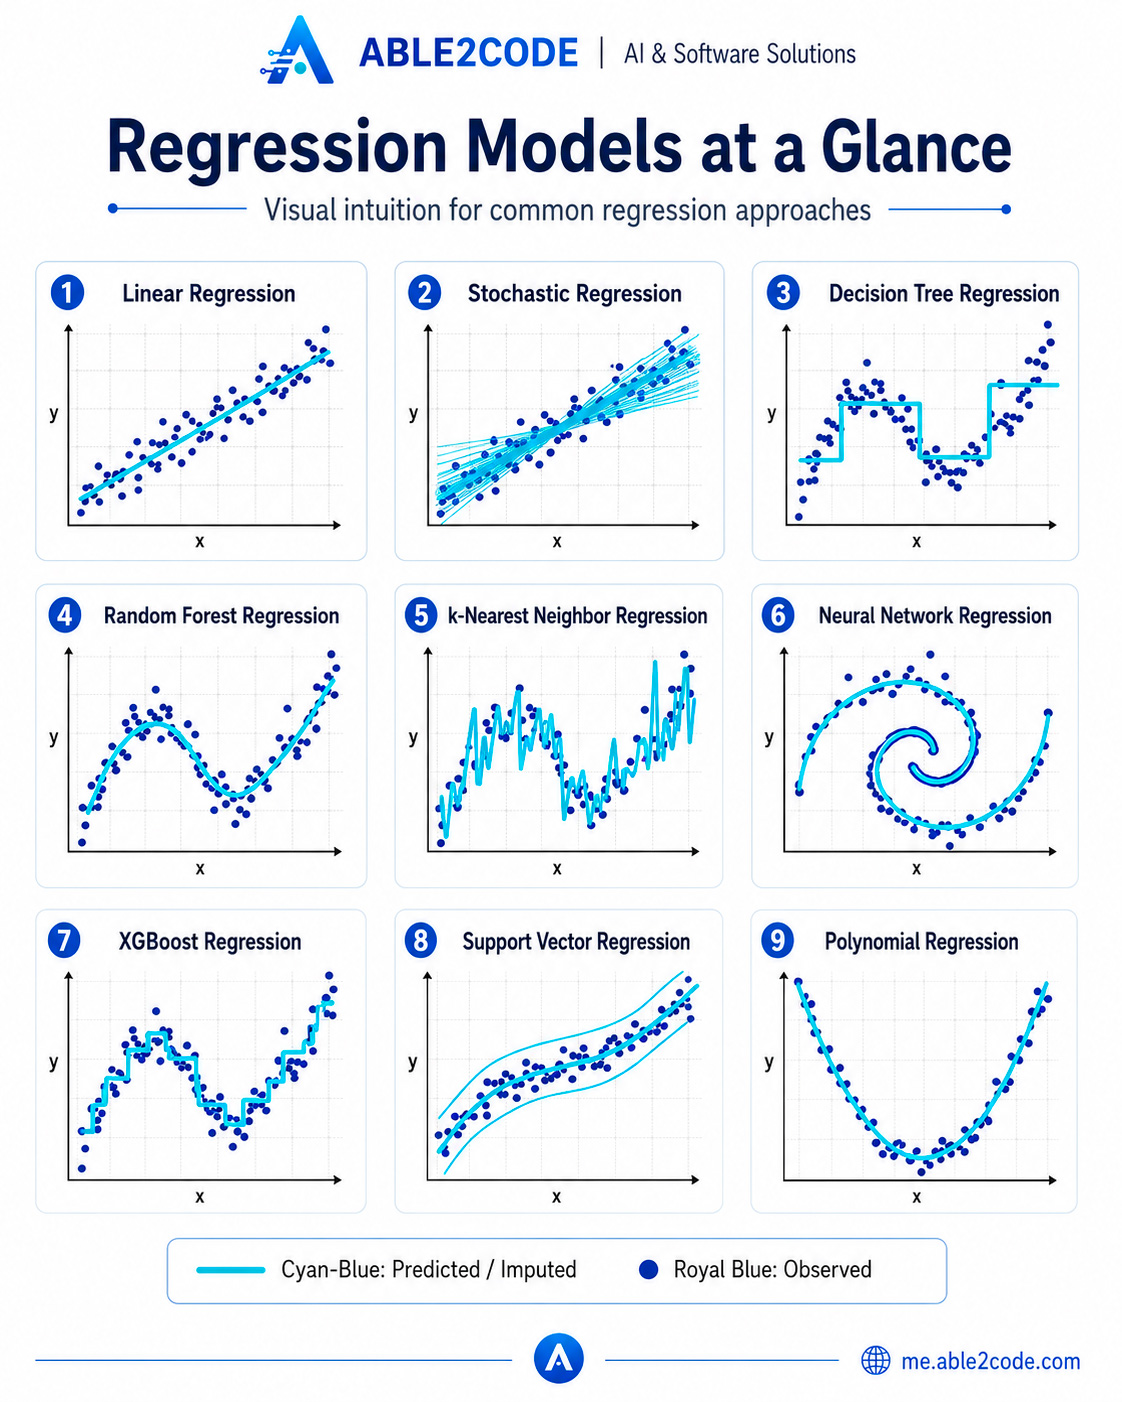
Analisi Dettagliata dei 9 Modelli Fondamentali
Esaminiamo la formulazione, i punti di forza e i casi di fallimento tipici dei 9 algoritmi di regressione cardine dello stato dell'arte.
1. Regressione Lineare (Linear Regression)
- Formula: \(f(\mathbf{x}) = \mathbf{w} \cdot \mathbf{x} + b = \sum_{j=1}^n w_j x_j + b\)
- Punti di Forza: Altamente interpretabile (ogni peso indica l'impatto marginale della feature), calcolo istantaneo con equazioni normali o discesa del gradiente, ottima robustezza di baseline.
- Limiti: Senza feature trasformate non cattura relazioni non lineari o interazioni; aggiungere queste feature può mantenerlo lineare nei parametri.
2. Regressione Polinomiale (Polynomial Regression)
- Formula: \(f(x) = b + w_1 x + w_2 x^2 + \dots + w_d x^d\)
- Punti di Forza: Modella traiettorie curve e andamenti curvilinei mantenendo la struttura lineare dei parametri.
- Limiti: All'aumentare del grado polinomiale \(d\), il rischio di overfitting esplode. Sensibilità estrema agli outlier sulle code della distribuzione.
3. Alberi Decisionali per Regressione (Decision Tree Regression)
- Meccanismo: Suddivide ricorsivamente lo spazio delle feature in iperpiani ortogonali paralleli agli assi coordinati. Assegna a ciascuna regione foglia il valore medio del target dei campioni contenuti.
- Punti di Forza: Non richiede normalmente feature scaling. Il supporto alle categorie dipende dalla libreria: gli alberi classici di scikit-learn richiedono una codifica numerica delle variabili categoriche.
- Limiti: Produce predizioni discontinue a gradino; soffre di forte instabilità (alta varianza) se non regolarizzato tramite potatura (pruning) o vincoli sulla profondità.
4. Random Forest Regression
- Meccanismo: Ensemble di centinaia di alberi decisionali indipendenti addestrati in parallelo tramite Bootstrapping (campionamento casuale con reinserimento) e Feature Bagging (scelta casuale di un sottoinsieme di feature a ogni split). La predizione finale è la media aritmetica di tutti gli alberi.
- Punti di Forza: Straordinaria robustezza all'overfitting, gestisce dataset ad alta complessità e rappresenta la scelta di default più solida per dati tabulari.
- Limiti: Maggiore consumo di RAM e tempi di inferenza superiori rispetto al singolo albero.
5. XGBoost Regression (eXtreme Gradient Boosting)
- Meccanismo: Algoritmo sequenziale in cui ogni nuovo albero viene addestrato specificamente per correggere i residui d'errore del modello complessivo precedente, ottimizzando una funzione di perdita quadratica regolarizzata con derivate prime e seconde (espansione di Taylor).
- Punti di Forza: Prestazioni allo stato dell'arte su benchmark tabulari, supporto nativo a regolarizzazione \(L_1/L_2\), gestione automatica dei valori mancanti.
- Limiti: Richiede un tuning accurato degli iperparametri (learning rate, max depth, subsample, lambda).
6. K-Nearest Neighbors Regression (KNN)
- Formula: \(f(\mathbf{x}) = \frac{1}{K} \sum_{i \in N_K(\mathbf{x})} y^{(i)}\)
- Punti di Forza: Modello non parametrico intuitivo e immediato; eccellente per pattern geografici locali o dati con relazioni spaziali dirette.
- Limiti: Collassa in alta dimensionalità a causa della dilatazione delle distanze geometriche; tempo di inferenza oneroso \(O(m \cdot n)\).
7. Support Vector Regression (SVR)
- Meccanismo: Cerca di adattare un iperpiano ottimale all'interno di una fascia di tolleranza \(\epsilon\) (epsilon-tube), penalizzando solo i punti esterni tramite variabili slack. Tramite il kernel trick (es. RBF), mappa i dati in spazi a dimensionalità superiore.
- Punti di Forza: Efficace in spazi con molte feature e pochi campioni; immune agli outlier contenuti all'interno del tubo di tolleranza.
- Limiti: Scalabilità scarsa oltre decine di migliaia di campioni (\(O(m^2)\)); sensibilità elevata ai parametri \(C\), \(\epsilon\) e \(\gamma\).
8. Reti Neurali per Regressione (Neural Network Regression)
- Meccanismo: Architetture deep multistrato con funzioni di attivazione non lineari (ReLU, GELU) e output lineare in grado di fungere da approssimatori universali di funzioni complesse.
- Punti di Forza: Capacità espressiva illimitata; ideale per dataset massivi multimodali (immagini, serie temporali, testo).
- Limiti: Richiede cluster GPU, milioni di parametri da ottimizzare, elevato rischio di overfitting e totale assenza di interpretabilità immediata (black-box).
9. Regressione Stocastica / Probabilistica
- Meccanismo: Invece di una predizione scalare deterministica, stima i parametri di una distribuzione di densità probabilistica \(p(y \mid \mathbf{x})\), come media \(\mu(\mathbf{x})\) e deviazione standard \(\sigma(\mathbf{x})\) (es. Gaussian Processes, Bayesian Neural Networks).
- Punti di Forza: Fornisce intervalli di confidenza rigorosi, indispensabili per la gestione del rischio finanziario, aerospaziale e medico.
- Limiti: Complessità matematica e costo computazionale significativo di inferenza.
Matrice di Scelta Operativa
La tabella seguente riassume i criteri di selezione per guidare la scelta dell'algoritmo in base ai requisiti di progetto:
| Algoritmo | Accuratezza | Interpretabilità | Tempo di Training | Scalabilità (\(m\)) | Robustezza Overfitting |
|---|---|---|---|---|---|
| Linear Regression | Bassa | ★★★ (Massima) | Istantaneo | Eccellente | Alta |
| Polynomial Reg. | Media | ★★☆ (Buona) | Molto Rapido | Buona | Bassa (cresce con \(d\)) |
| Decision Tree | Media | ★★☆ (Grafica) | Rapido | Buona | Bassa (senza pruning) |
| Random Forest | Alta | ★☆☆ (Feature Imp.) | Medio-Lento | Buona | Alta |
| XGBoost | Eccellente | ★☆☆ (Feature Imp.) | Medio | Ottima | Media (richiede tuning) |
| KNN Regression | Media | ★★☆ (Intuitiva) | Nullo (Lazy) | Pessima su \(m > 10^5\) | Media |
| SVR | Alta | ☆☆☆ (Nulla) | Lento su \(m\) grandi | Bassa | Alta |
| Neural Network | Eccellente | ☆☆☆ (Nulla) | Molto Lento | Ottima (con GPU) | Bassa (richiede dropout) |
| Stochastic Reg. | Media-Alta | ★☆☆ (Probabilistica) | Medio-Lento | Media | Alta |
Esempio Comparativo in Python con Scikit-Learn
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.ensemble import RandomForestRegressor
from sklearn.svm import SVR

# Dataset simulato non-lineare
np.random.seed(42)
X = np.sort(np.random.rand(200, 1) * 10.0, axis=0)
y = np.sin(X).ravel() + np.random.randn(200) * 0.15

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)

# Configurazione modelli a confronto
models = {
    "Linear Regression": LinearRegression(),
    "Ridge Regularized": Ridge(alpha=1.0),
    "Random Forest (100 alberi)": RandomForestRegressor(n_estimators=100, random_state=42),
    "SVR (Kernel RBF)": SVR(kernel="rbf", C=10.0, epsilon=0.1)
}

print("=== CONFRONTO PRESTAZIONI MODELLI DI REGRESSIONE ===\n")
for name, model in models.items():
    model.fit(X_train, y_train)
    y_pred = model.predict(X_test)
    mse = mean_squared_error(y_test, y_pred)
    r2 = r2_score(y_test, y_pred)
    print(f"[{name}]")
    print(f"  MSE: {mse:.4f} | R² Score: {r2:.4f}\n")
Conclusioni
Non partire mai dal modello più complesso: costruisci sempre una solida baseline lineare, misura l'errore sul set di convalida e introduci modelli ad albero (Random Forest, XGBoost) o reti neurali solo quando la complessità dei dati lo richiede espressamente.
Verifica se il concetto è passato
Perché una Random Forest non dovrebbe essere il primo modello provato in automatico?
Controlla la risposta
Perché una baseline lineare è più veloce e interpretabile: chiarisce quanto valore aggiunga davvero la complessità successiva.
Domande frequenti
Perché la regressione lineare non basta per tutti i problemi pratici?
La regressione lineare assume che l'effetto delle feature sul target sia strettamente additivo e proporzionale. Nei sistemi fisici, biologici e finanziari reali le relazioni sono spesso sature, a gradini, cicliche o fortemente non lineari.
Quando conviene usare XGBoost rispetto a una Random Forest?
XGBoost è ideale quando si cerca la massima accuratezza predittiva possibile su dati tabulari complessi e si ha tempo per il tuning fine degli iperparametri. Random Forest è preferibile come baseline solido, veloce da addestrare in parallelo e meno sensibile all'overfitting spontaneo.
Qual è il limite principale della regressione K-Nearest Neighbors (KNN)?
La regressione KNN soffre drasticamente della maledizione della dimensionalità: all'aumentare del numero di feature, lo spazio diventa vuoto e la distanza euclidea perde significato discriminante. La ricerca brute-force confronta tutti i campioni; indici ad albero o approssimati possono ridurre il costo, con vantaggi che dipendono dalla dimensionalità.
Come funziona il trucco del kernel nella Support Vector Regression (SVR)?
Il kernel calcola prodotti scalari in uno spazio di feature implicito. In quello spazio la SVR apprende una funzione con perdita epsilon-insensitive: piccoli errori non vengono penalizzati. Non cerca una separazione tra classi e non garantisce un adattamento perfetto.
Cos'è la regressione stocastica o probabilistica?
A differenza dei modelli deterministici che restituiscono un singolo valore puntuale, la regressione probabilistica stima l'intera distribuzione di probabilità del target condizionata agli input (es. media e varianza), consentendo di quantificare formalmente l'incertezza e il rischio associato alla predizione.
Fonti e approfondimenti
- Scikit-learn - Support Vector Regression
- Scikit-learn - Decision Trees e variabili categoriche
- Tianqi Chen, Carlos Guestrin - XGBoost: A Scalable Tree Boosting System (KDD)
- Leo Breiman - Random Forests (Machine Learning Journal)
- Alex J. Smola, Bernhard Schölkopf - A Tutorial on Support Vector Regression
- Scikit-Learn Regression User Guide
Continua da qui

Diagnostica dei Modelli di Machine Learning, Metriche e Alberi Decisionali (XGBoost)
Strategia di sviluppo ML: Train/CV/Test split, diagnosi Bias vs Varianza con Learning Curves, metriche per dati sbilanciati e Random Forest/XGBoost.

Machine Learning Supervisionato: Regressione Lineare e Discesa del Gradiente
Formulazione matematica della regressione univariata e multivariata, funzione di costo MSE, discesa del gradiente e ottimizzazione vettorizzata con NumPy.

Mappa del Machine Learning: guida completa dai fondamenti alle architetture moderne
Guida esaustiva al Machine Learning: definizioni formali, tassonomia completa, paradigmi di apprendimento e workflow operativo end-to-end.