
In questo articolo
Cosa saprai fare
- Distinguere apprendimento supervisionato, non supervisionato e per rinforzo
- Riconoscere feature, target, modello e metrica
- Orientarti nel ciclo di vita di un progetto ML
Prima di iniziare
- Nessuna conoscenza di Machine Learning
- Python non è ancora necessario
In breve
- Il Machine Learning ribalta la programmazione classica: non si codificano regole manuali, ma si estraggono pattern matematici dai dati.
- La definizione di Tom Mitchell formalizza l'apprendimento attraverso la triade Esperienza (E), Compito (T) e Misura di Prestazione (P).
- Supervisionato, non supervisionato e per rinforzo descrivono paradigmi di apprendimento. Deep learning e modelli generativi sono dimensioni trasversali, non un quarto gruppo esclusivo.
- Un workflow di Machine Learning industriale richiede un ciclo iterativo che va dalla raccolta dati all'ingegnerizzazione delle feature, fino a diagnostica e deploy.
Il Nuovo Paradigma Computazionale
Per decenni, lo sviluppo software ha seguito un principio deterministico: per risolvere qualsiasi problema, un ingegnere doveva comprendere a fondo la logica del dominio, scomporla in condizioni booleane e codificare esplicitamente ogni singola regola all'interno del programma.
Questo modello classico entra in crisi quando affronta la complessità del mondo reale. Come si programma esplicitamente un veicolo a riconoscere un pedone che attraversa sotto la pioggia battente con illuminazione variabile? Come si scrive una sequenza di if/else per identificare una microfrattura microscopica su una pala di turbina aeronautica scansionata al laser?
Il Machine Learning (ML) rappresenta il superamento di questa barriera epistemologica:
Programmazione Classica:  [ Dati ] + [ Regole ]  ───►  [ Risposte ]

Machine Learning:         [ Dati ] + [ Risposte ] ───►  [ Modello / Regole ]
Anziché istruire il calcolatore su come giungere al risultato passo dopo passo, gli forniamo un'architettura parametrizzata e un algoritmo di ottimizzazione capace di aggiustare i propri parametri interni confrontando le previsioni con i dati reali.
La Definizione Operativa Formale
Nel 1997, il professore di computer science Tom Mitchell propose una definizione matematica e formale che ancora oggi costituisce il metro di riferimento per qualsiasi sistema di intelligenza artificiale:
"Un programma per calcolatore apprende dall'esperienza \(E\), rispetto a una classe di compiti \(T\) e a una misura di prestazione \(P\), se le sue prestazioni nel compito \(T\), misurate da \(P\), migliorano con l'esperienza \(E\)."
Per comprendere questa triade in un contesto ingegneristico e industriale, consideriamo un sistema di controllo qualità robotico avanzato:
- Compito (\(T\)): Riconoscere e isolare componenti con microfratture su una linea di produzione aerospaziale ad altissima velocità.
- Esperienza (\(E\)): Uno storico di \(500.000\) scansioni tomografiche tridimensionali precedentemente verificate e annotate da metallurgisti esperti.
- Misura di Prestazione (\(P\)): La percentuale di difetti intercettati (Recall) con un tasso di falsi allarmi inferiore allo \(0.05\%\).
Se il software, processando un numero crescente di scansioni (\(E\)), riduce i falsi allarmi e aumenta i pezzi difettosi identificati (\(P\)) senza modifiche al codice sorgente, allora il sistema sta effettivamente apprendendo.
La Grande Tassonomia del Machine Learning
La mappa seguente distingue tre paradigmi di apprendimento e introduce poi le reti profonde. Non sono quattro categorie disgiunte: un Transformer, per esempio, può essere pre-addestrato con obiettivi auto-supervisionati e poi adattato con dati etichettati.
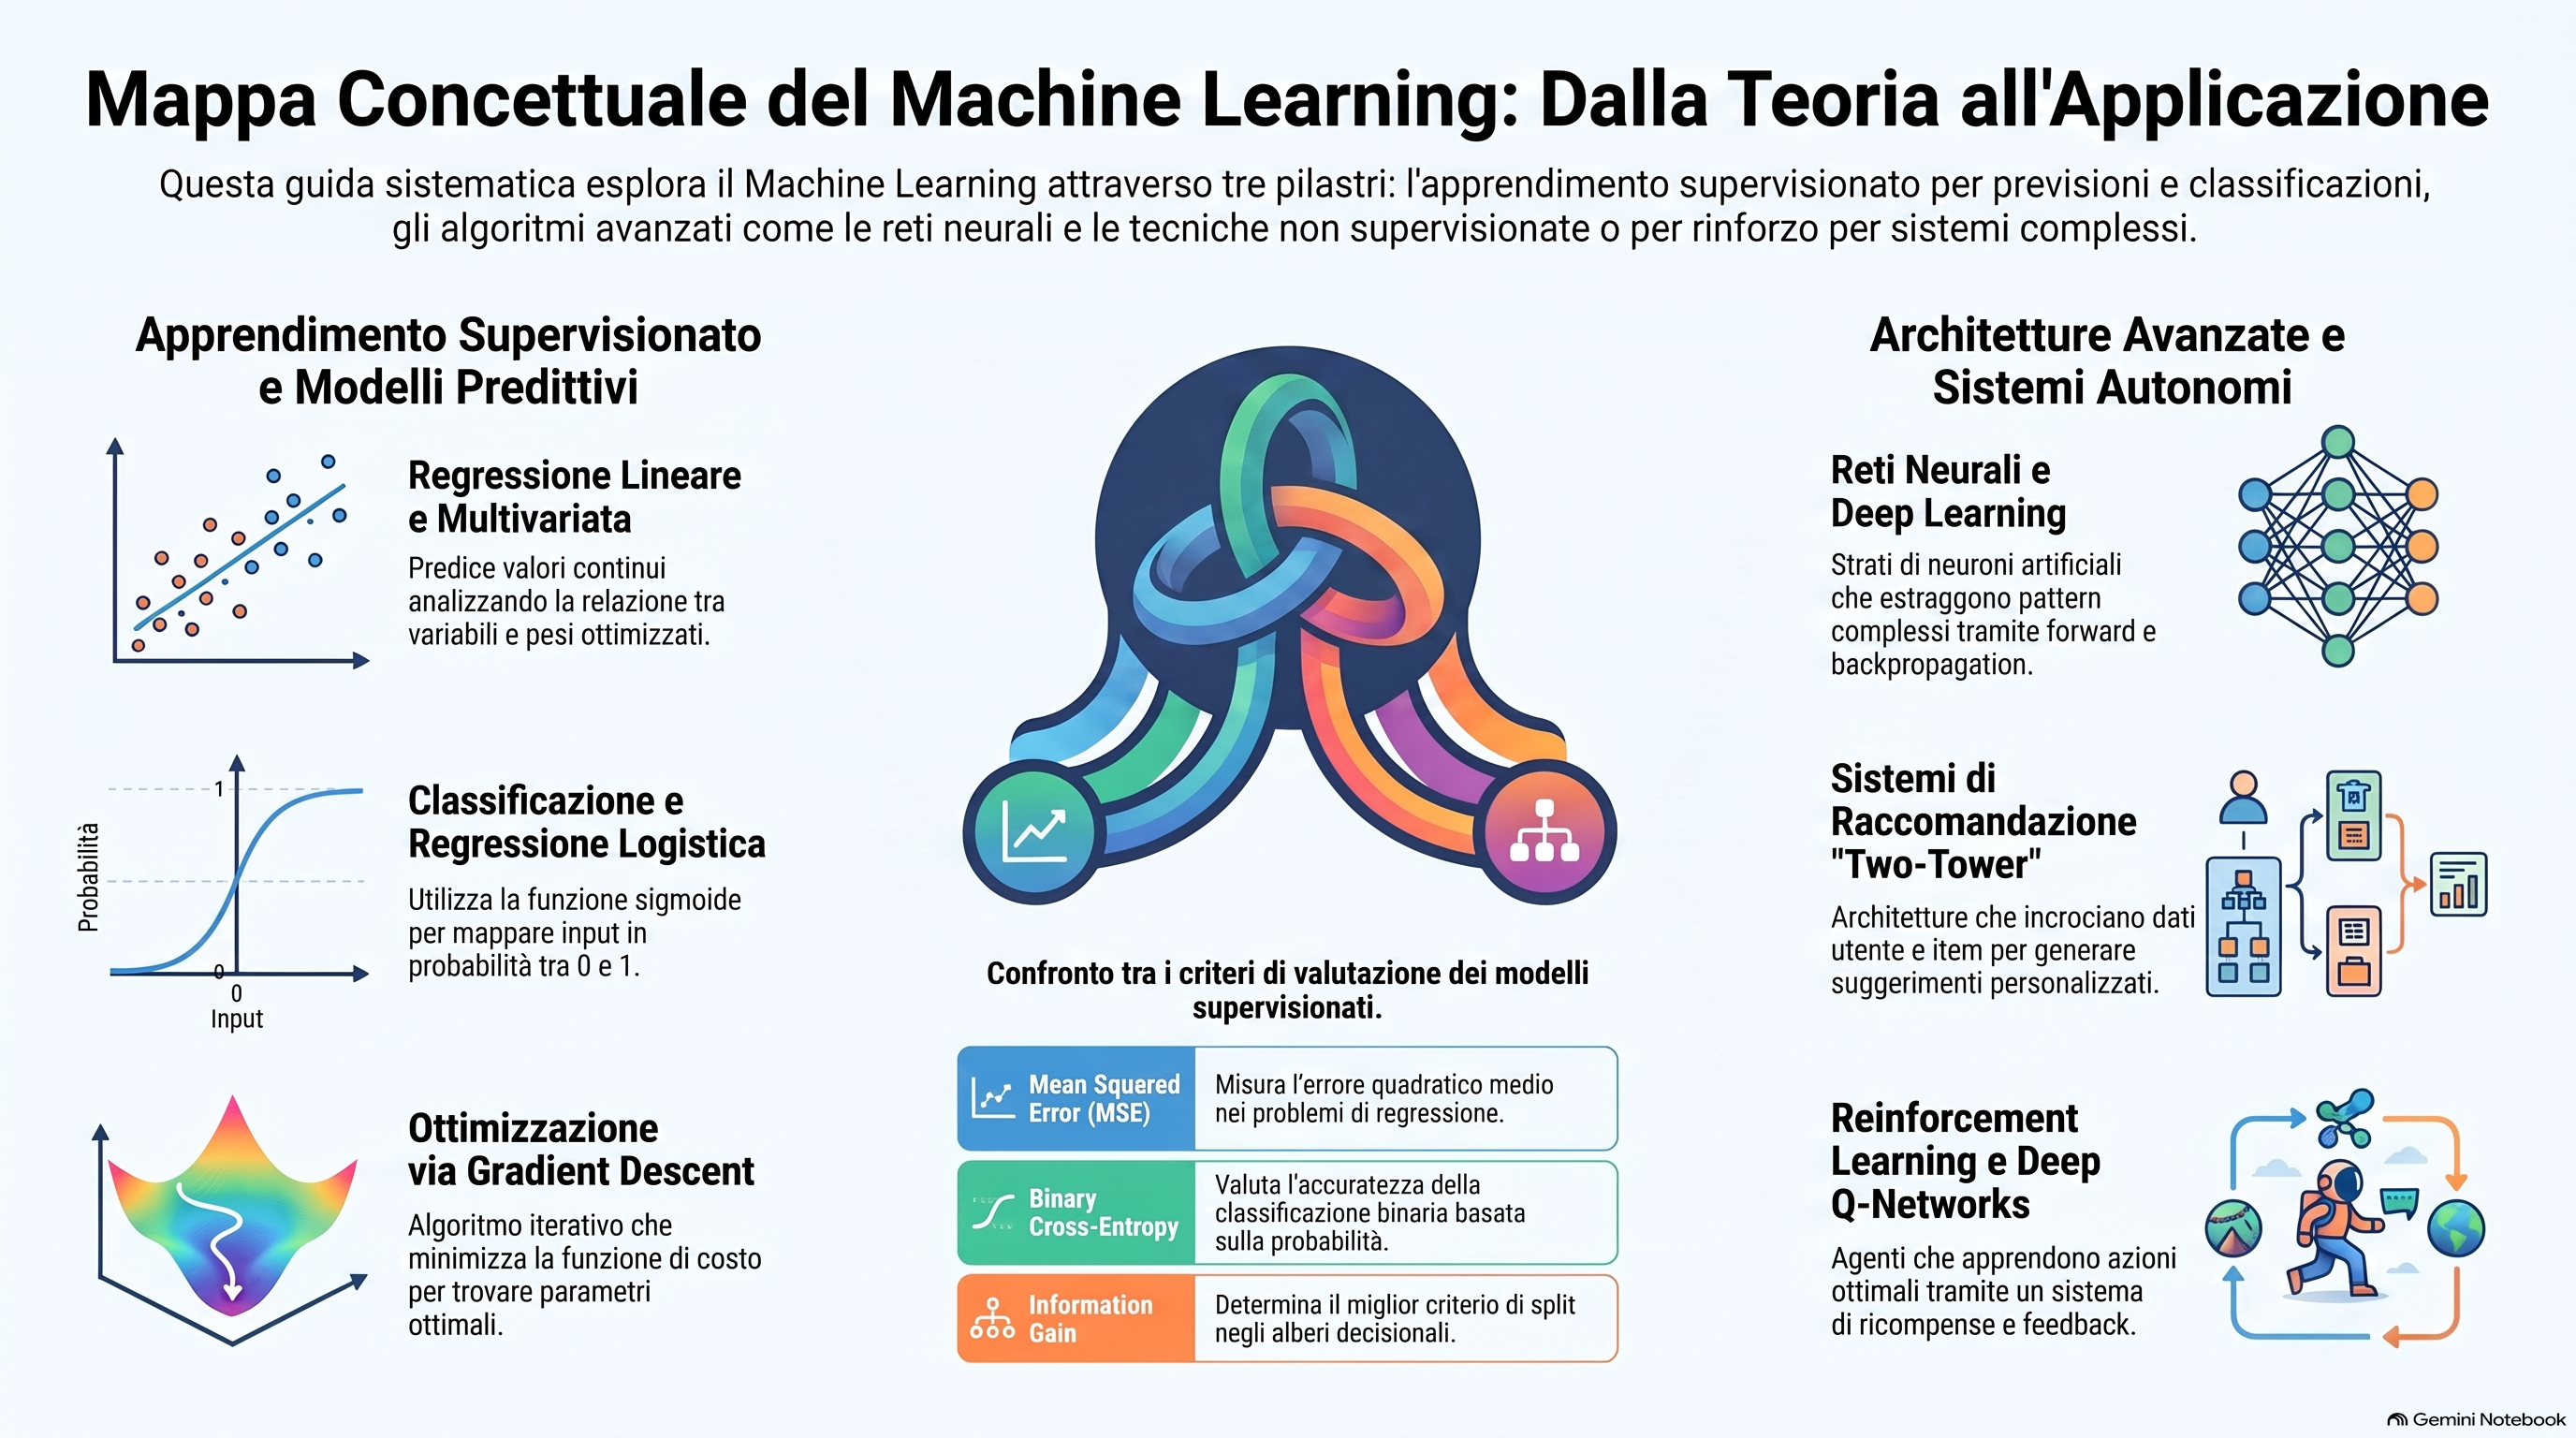
1. Apprendimento Supervisionato (Supervised Learning)
Il modello viene addestrato su un dataset in cui ogni osservazione \(\mathbf{x}^{(i)}\) è associata a un'etichetta target nota \(y^{(i)}\): \[\mathcal{D} = \left\lbrace (\mathbf{x}^{(1)}, y^{(1)}), (\mathbf{x}^{(2)}, y^{(2)}), \dots, (\mathbf{x}^{(m)}, y^{(m)}) \right\rbrace\]
Si divide principalmente in:
- Regressione: Il target \(y\) è una variabile continua reale (\(y \in \mathbb{R}\)). Esempi: stima del consumo energetico, previsione dei prezzi, calcolo del tempo di vita residuo di componenti industriali.
- Classificazione: Il target \(y\) è una categoria discreta (\(y \in \{0, 1\}\) o \(y \in \{1, \dots, K\}\)). Esempi: diagnostica medica, rilevamento spam, identificazione di frodi creditizie.
2. Apprendimento Non Supervisionato (Unsupervised Learning)
Il dataset è privo di etichette target (\(y\) non esiste). L'algoritmo deve scoprire autonomamente la struttura geometrica e probabilistica intrinseca dei dati:
- Clustering: Raggruppamento di osservazioni simili in gruppi omogenei (es. K-Means, DBSCAN).
- Anomaly Detection: Modellazione del comportamento nominale per identificare deviazioni anomale (es. intrusioni informatiche, guasti hardware rari).
- Riduzione della Dimensionalità: Compressione delle feature preservando la massima informazione (es. PCA, t-SNE, UMAP).
3. Apprendimento per Rinforzo (Reinforcement Learning)
Un agente autonomo interagisce con un ambiente dinamico attraverso un ciclo continuo di percezione di Stato (\(s\)), esecuzione di un'Azione (\(a\)) e ricezione di una Ricompensa (\(r\)). L'obiettivo è massimizzare il ritorno cumulativo futuro nel lungo termine attraverso l'ottimizzazione dell'Equazione di Bellman.
Architetture trasversali: Deep Learning e Transformer
Reti neurali multistrato capaci di apprendere gerarchie complesse di rappresentazioni non lineari. Nei moderni Transformer, il meccanismo di auto-attenzione (Self-Attention) modella le correlazioni globali tra elementi di una sequenza in parallelo, rivoluzionando il Natural Language Processing (LLM), la Computer Vision e la biologia computazionale.
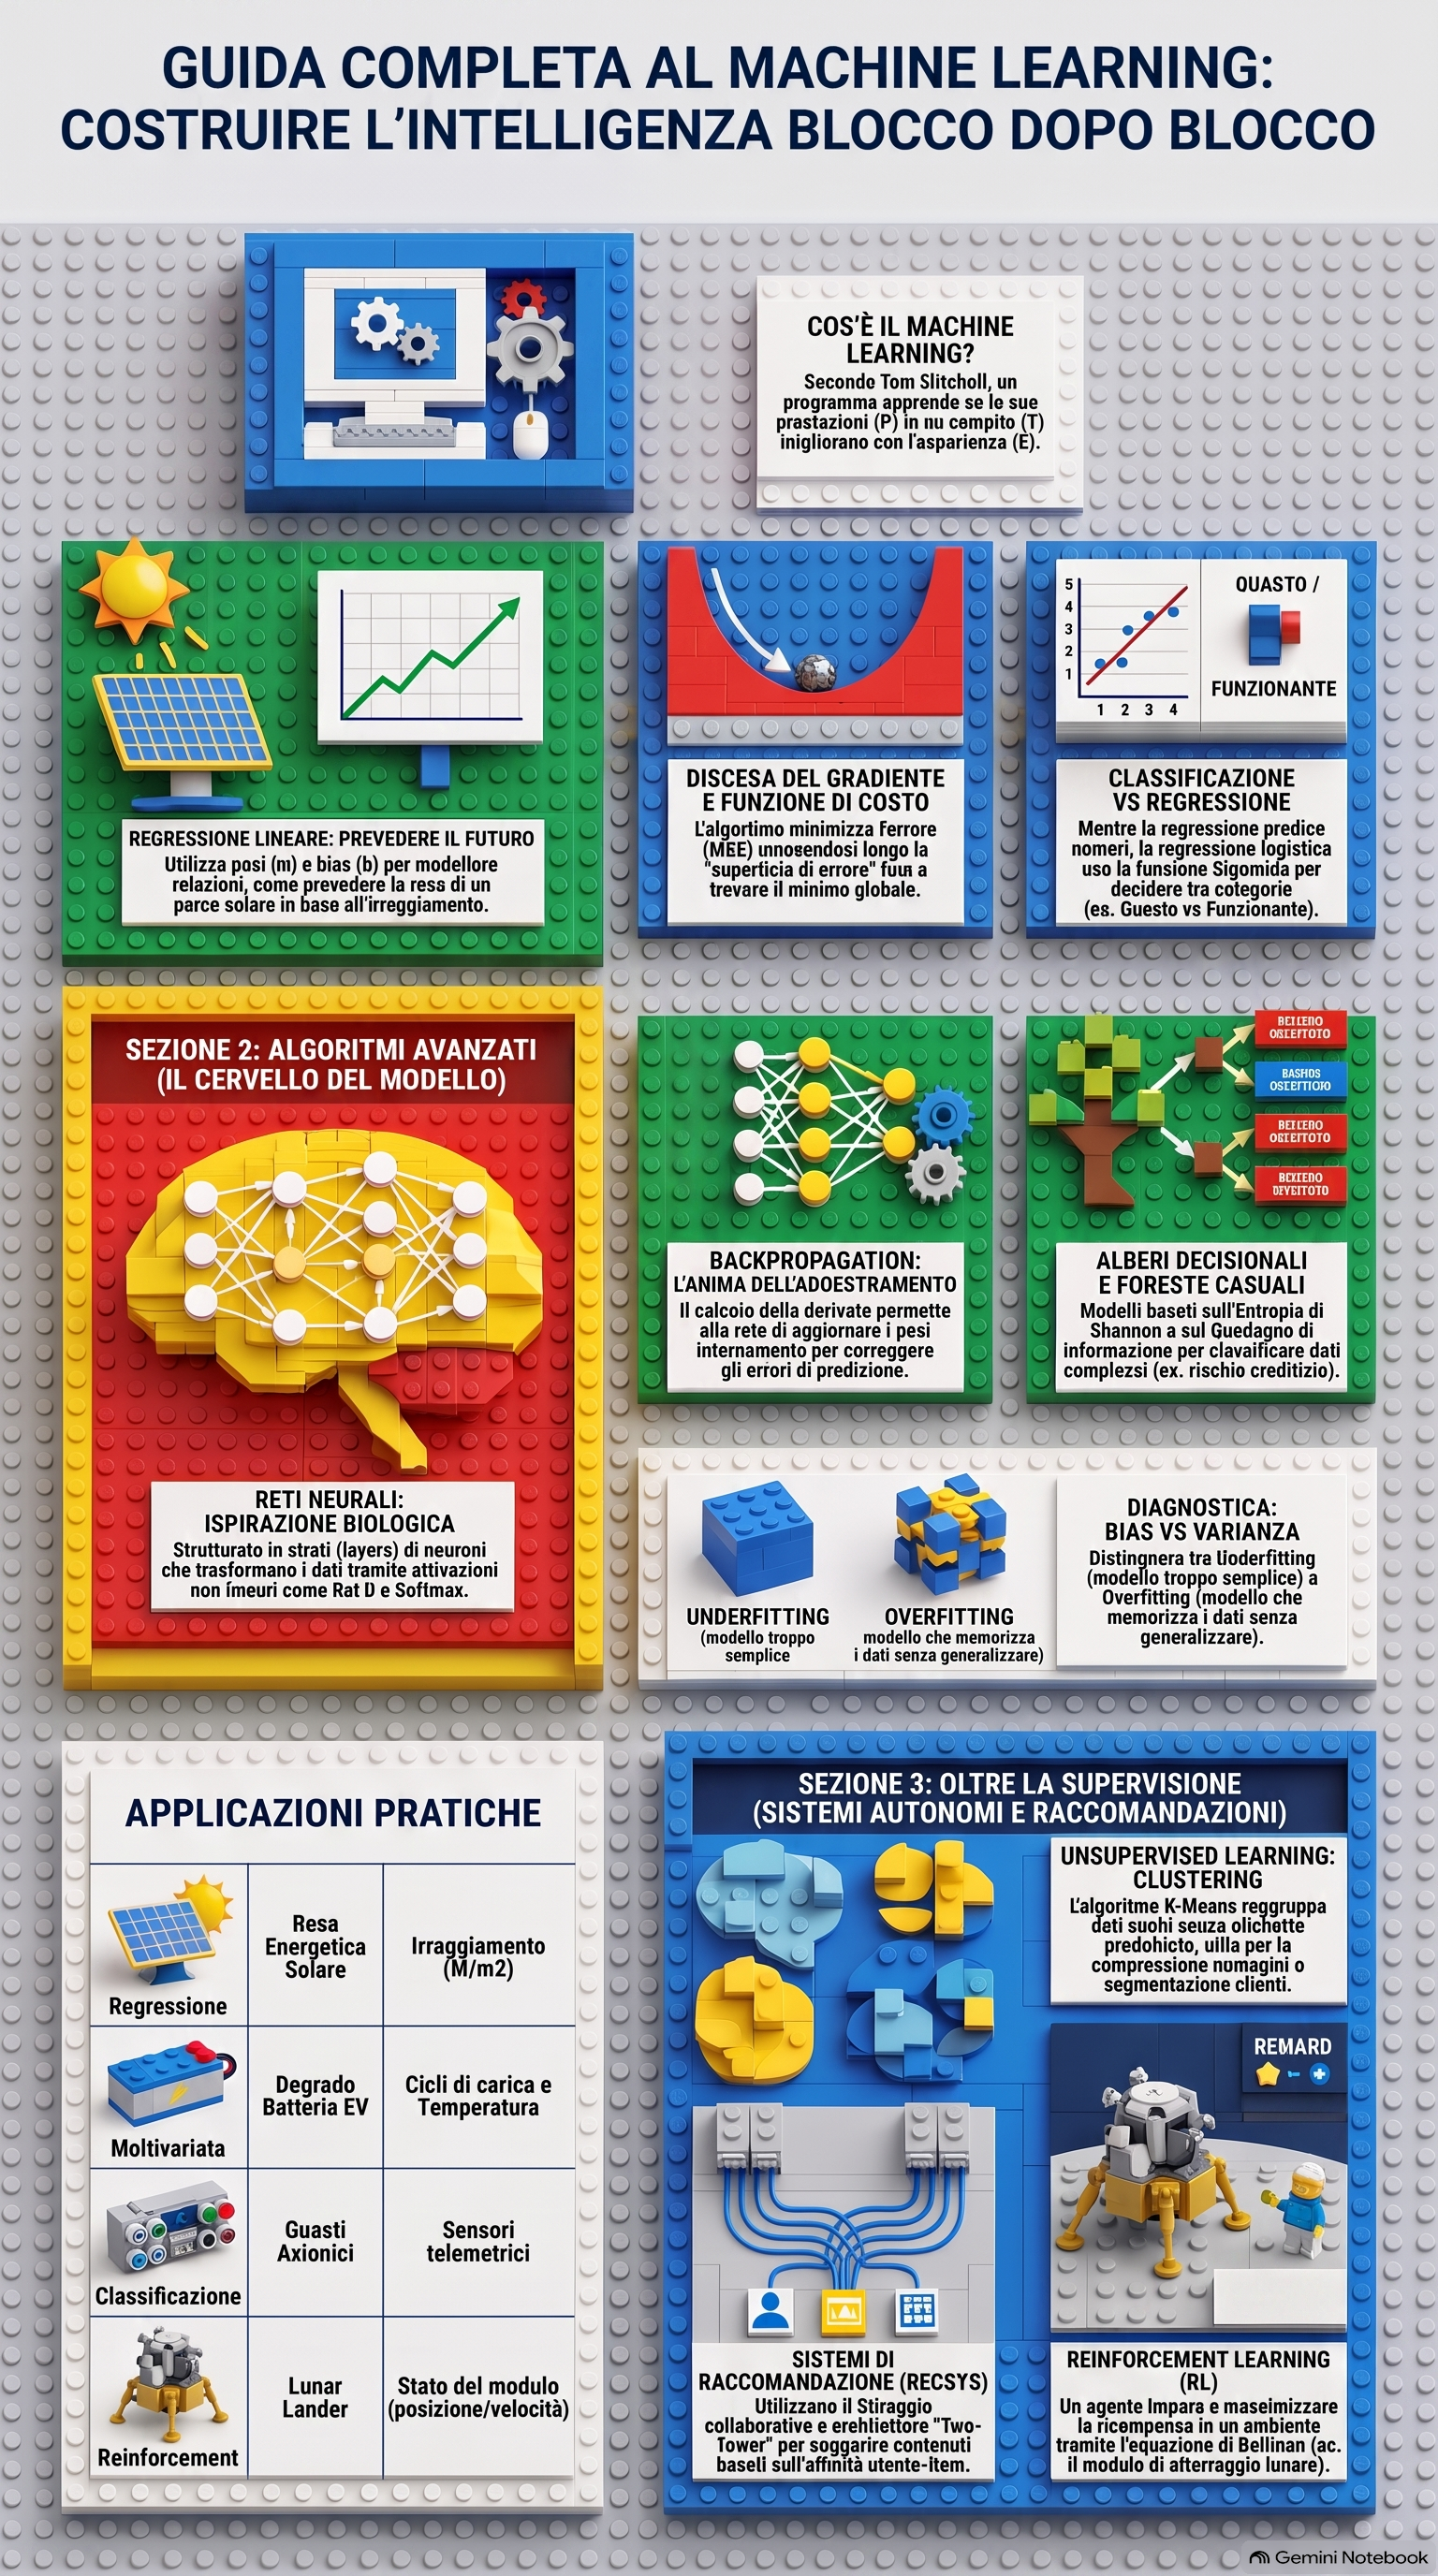
Il Ciclo di Vita di un Progetto di Machine Learning
Costruire un sistema di Machine Learning in produzione non si riduce a invocare .fit() su una libreria. È un processo ingegneristico rigoroso articolato in sei stadi sequenziali e iterativi:
[1. Definizione Problema & Metriche]
                 │
                 ▼
[2. Raccolta & Validazione Dati]
                 │
                 ▼
[3. Ingegnerizzazione delle Feature] ◄────────┐
                 │                            │ Iterazione
                 ▼                            │ Diagnostica
[4. Addestramento & Selezione Modelli]        │ e Tuning
                 │                            │
                 ▼                            │
[5. Diagnostica: Bias / Varianza / Errori] ───┘
                 │
                 ▼
[6. Deployment, Monitoraggio & Drift Analysis]
- Inquadramento del Problema: Definire con precisione se il task è una regressione, classificazione o ranking, e stabilire la funzione di costo e la metrica di business (\(F_1\)-score, MSE, latency).
- Separazione dei Dati: Definire training, validazione e test prima di apprendere trasformazioni. Le proporzioni dipendono dal dataset; serie temporali e gruppi richiedono split specifici.
- Ingegneria dei Dati: Apprendere imputazione, scaling e codifiche sul solo training, poi applicare le stesse trasformazioni a validazione e test. Questo previene una forma comune di data leakage.
- Analisi degli Errori (Error Analysis): Ispezionare manualmente i campioni su cui il modello fallisce per individuare pattern sistematici di debolezza.
- Monitoraggio Post-Deploy: Tracciare la deriva dei dati (Data Drift) e la deriva dei concetti (Concept Drift) per pianificare tempestivamente il riaddestramento.
Il Percorso Formativo
Le lezioni del corso esplorano nel dettaglio matematico e implementativo ogni pilastro:
- Dalle formule di discesa del gradiente e ottimizzazione convessa nei modelli lineari;
- Alla stabilità numerica e backpropagation nelle reti neurali profonde;
- Fino al fine-tuning efficiente con LoRA e QLoRA e al Deep Q-Learning in simulatori fisici.
Verifica se il concetto è passato
Se possiedi esempi di email con l'etichetta spam/non spam, in quale famiglia di apprendimento sei?
Controlla la risposta
Apprendimento supervisionato, perché ogni esempio possiede un target noto che il modello deve imparare a prevedere.
Domande frequenti
Qual è la differenza fondamentale tra programmazione tradizionale e Machine Learning?
Nella programmazione tradizionale lo sviluppatore scrive esplicitamente dati e regole logiche per ottenere risposte. Nel Machine Learning i parametri si apprendono dai dati mediante un obiettivo. Risposte note sono tipiche del supervisionato; altri paradigmi usano struttura dei dati, obiettivi auto-supervisionati o ricompense.
Come si definisce formalmente un algoritmo che apprende?
Secondo la formulazione di Tom Mitchell, un programma apprende dall'esperienza E rispetto a un compito T e a una misura di prestazione P se le sue prestazioni nel compito T, valutate tramite P, migliorano progressivamente all'aumentare dell'esperienza E.
Come si distinguono paradigmi di apprendimento e architetture?
Supervisionato, non supervisionato e per rinforzo distinguono il segnale di apprendimento. Esistono anche approcci semi-supervisionati e auto-supervisionati. Il deep learning usa reti profonde e può attraversare questi paradigmi; generativo descrive invece un tipo di modellazione e di output.
Che ruolo hanno le feature nel Machine Learning?
Le feature sono le variabili misurabili o gli attributi estratti dai dati grezzi che descrivono il fenomeno da modellare. La qualità e la rappresentazione delle feature determinano direttamente la capacità del modello di generalizzare.
Cosa si intende per approccio Data-Centric?
L'approccio Data-Centric sostiene che, una volta selezionata un'architettura algoritmica solida, i maggiori guadagni di accuratezza si ottengono migliorando sistematicamente la qualità, la consistenza e la pulizia dei dati, anziché apportare continue micro-modifiche al codice del modello.
Fonti e approfondimenti
Continua da qui

Architettura Transformer e Meccanismo di Attenzione: Guida Completa agli LLM
Come funzionano i Transformer: limiti di RNN/LSTM, Positional Encoding, Scaled Dot-Product Attention, Multi-Head Attention ed Encoder-Decoder.

Diagnostica dei Modelli di Machine Learning, Metriche e Alberi Decisionali (XGBoost)
Strategia di sviluppo ML: Train/CV/Test split, diagnosi Bias vs Varianza con Learning Curves, metriche per dati sbilanciati e Random Forest/XGBoost.

Guida completa agli algoritmi di regressione: 9 modelli a confronto e matrice di scelta
Analisi tecnica dei 9 principali algoritmi di regressione: da Linear a Random Forest, XGBoost, SVR e Neural Networks, con matrice decisionale.