
In questo articolo
Cosa saprai fare
- Seguire tokenizzazione, embedding e positional encoding
- Calcolare concettualmente Q, K, V e attention
- Distinguere encoder, decoder e architetture ibride
Prima di iniziare
- Lezione 5: reti neurali
- Matrici, Softmax ed embedding
In breve
- I Transformer parallelizzano il calcolo sulle posizioni di una sequenza già disponibile. La generazione autoregressiva ordinaria continua invece un token alla volta.
- Il Positional Encoding sinusoidale reintroduce l'informazione di ordine sequenziale all'interno degli embedding vettoriali.
- Il meccanismo di Scaled Dot-Product Attention calcola la rilevanza tra matrici di Query (Q), Key (K) e Value (V).
- Le tre architetture fondamentali (Encoder-only, Decoder-only, Encoder-Decoder) coprono comprensione, generazione e traduzione.
La Rivoluzione dei Transformer
Prima del 2017, l'elaborazione del linguaggio naturale (NLP) e delle sequenze temporali era dominata dalle Reti Neurali Ricorrenti (RNN) e dalle loro evoluzioni con cancelli (LSTM e GRU).
Tuttavia, queste architetture presentavano due limiti strutturali importanti:
- Collo di Bottiglia Sequenziale: L'elaborazione del token \(t\) richiedeva obbligatoriamente il completamento dello stato nascosto al tempo \(t-1\). Questo limitava la parallelizzazione lungo il tempo, pur consentendo operazioni parallele su batch e matrici.
- Perdita di Memoria a Lungo Raggio: Nonostante le celle di memoria delle LSTM, l'informazione compressa lungo centinaia di passaggi temporali tendeva a sbiadire (Vanishing Gradient), rendendo più difficile collegare concetti distanti nel testo.
Nel celebre articolo scientifico "Attention Is All You Need" (Vaswani et al.), i ricercatori di Google introdussero i Transformer: un'architettura che elimina completamente la ricorrenza, elaborando l'intera sequenza di token in parallelo tramite il meccanismo di Auto-Attenzione (Self-Attention). Questo vale per le posizioni già disponibili, come nel training con teacher forcing o nel prefill del prompt; la generazione autoregressiva ordinaria resta sequenziale.
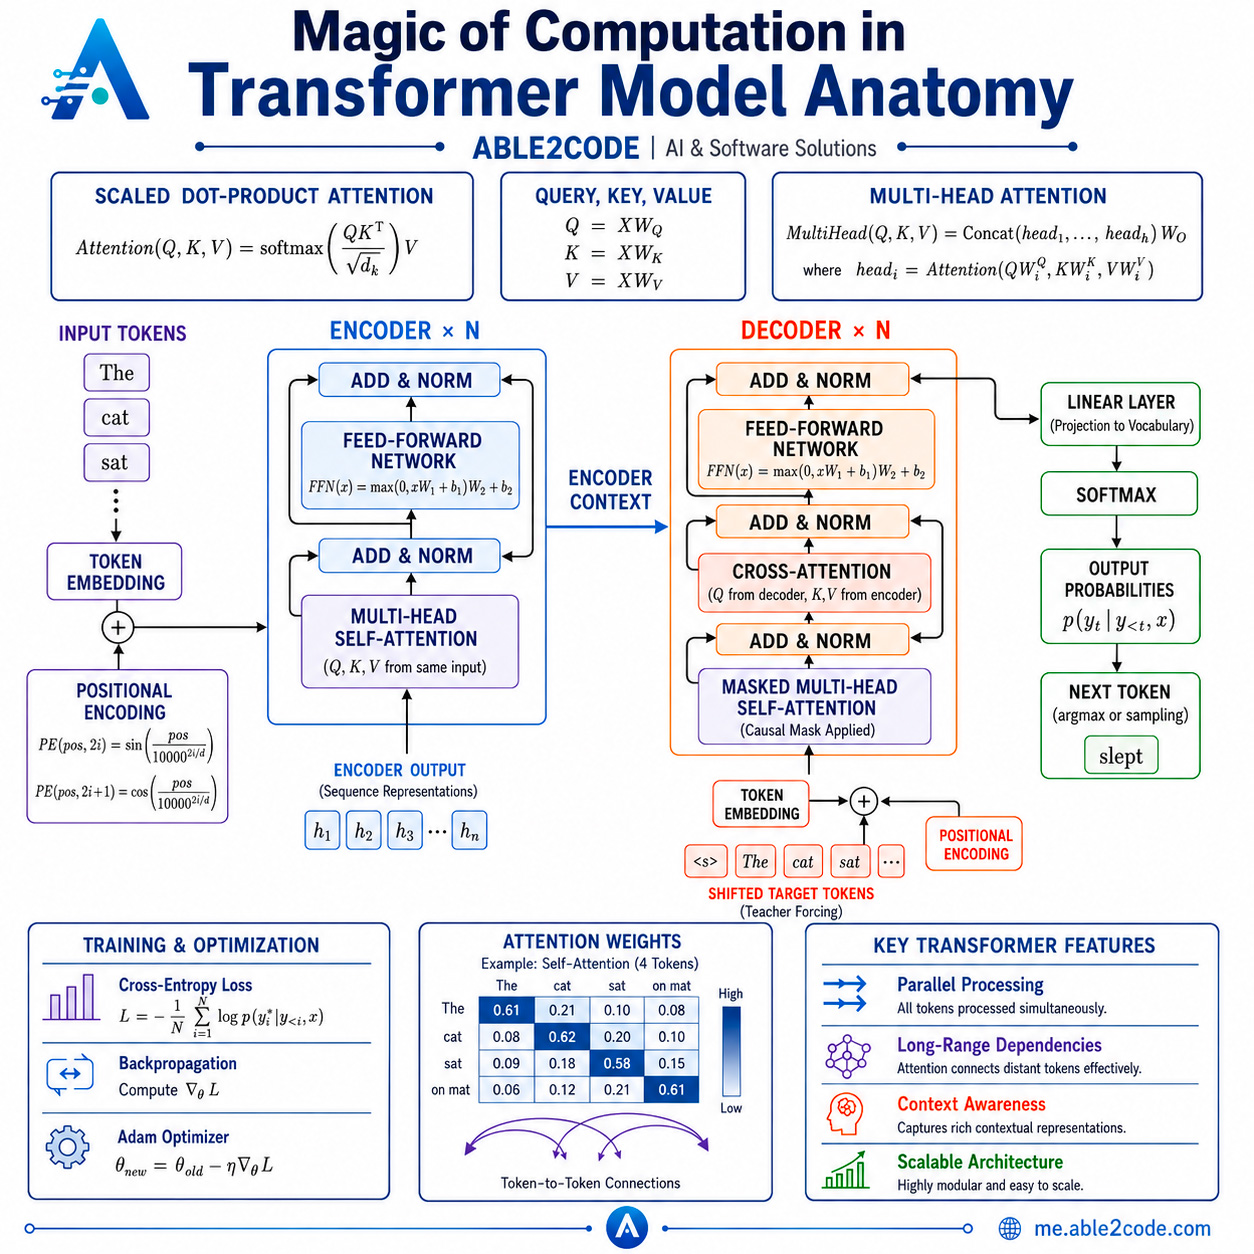
Il Workflow End-to-End di un Transformer
L'elaborazione di un testo all'interno di un Transformer segue una pipeline rigorosa in 7 fasi:
[ Testo Grezzo ]
       │
       ▼
[ 1. Tokenizzazione ] ──────────► Suddivisione in subword token (es. BPE)
       │
       ▼
[ 2. Embedding Layer ] ─────────► Vettori densi nello spazio R^d
       │
       ▼
[ 3. Positional Encoding ] ─────► Somma di frequenze sinusoidali PE(pos)
       │
       ▼
[ 4. Multi-Head Attention ] ────► Calcolo parallelo di Q, K, V
       │
       ▼
[ 5. Add & Norm (Residui) ] ────► Skip connection: x + Attention(x)
       │
       ▼
[ 6. Feed-Forward Network ] ────► Trasformazione non lineare densa
       │
       ▼
[ 7. Linear & Softmax Output ] ─► Distribuzione di probabilità sui token
Positional Encoding (Codifica Posizionale)
Senza informazioni posizionali e senza maschere, la self-attention è equivariante alle permutazioni: riordinando gli input si riordinano allo stesso modo gli output. Non dispone quindi di una rappresentazione esplicita della posizione. Il mascheramento causale introduce già un vincolo direzionale.
Nel Transformer originale si somma agli embedding una codifica sinusoidale. È una scelta tra diverse: altre architetture usano embedding posizionali appresi o rotazioni come RoPE. La formula originale è:
\[PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right)\]
\[PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right)\]
Dove \(pos\) è la posizione temporale del token nella frase e \(i\) è l'indice della dimensione lungo lo spazio di embedding \(d_{\text{model}}\).
La Formulazione Matematica della Scaled Dot-Product Attention
Il cuore computazionale del Transformer è l'operazione di attenzione scalata. A partire dalla matrice di rappresentazione dei token \(X \in \mathbb{R}^{T \times d_{\text{model}}}\), il modello calcola tre proiezioni lineari mediante matrici di peso addestrabili \(W_Q, W_K, W_V\):
- Query (\(Q = X W_Q \in \mathbb{R}^{T \times d_k}\)): Rappresenta ciò che ogni token sta cercando;
- Key (\(K = X W_K \in \mathbb{R}^{T \times d_k}\)): Rappresenta le etichette informative usate per valutare la rilevanza;
- Value (\(V = X W_V \in \mathbb{R}^{T \times d_v}\)): Rappresenta il contenuto informativo effettivo da aggregare.
\[\mathbf{\text{Attention}(Q, K, V) = \text{softmax}\left( \frac{Q K^T}{\sqrt{d_k}} \right) V}\]
Analisi dei Componenti della Formula
- \(Q K^T\): Prodotto scalare che calcola la matrice quadrata di affinità grezza (\(T \times T\)) tra ogni coppia di token della frase;
- Divisione per \(\sqrt{d_k}\): Essenziale per evitare che per grandi dimensioni \(d_k\) il prodotto scalare cresca eccessivamente, spingendo la softmax verso zone con gradienti piatti;
- \(\text{softmax}(\dots)\): Converte i punteggi di affinità in coefficienti di peso probabilistici sommati a \(1\);
- Moltiplicazione per \(V\): Calcola la combinazione lineare dei valori pesata per l'attenzione reciproca.
Multi-Head Attention (Attenzione Multi-Testa)
Anziché calcolare una singola attenzione globale, il modello proietta \(Q, K, V\) in \(h\) sottospazi differenti in parallelo (heads). Questo consente di catturare simultaneamente diverse relazioni semantiche, sintattiche e grammaticali a distanze differenti:
\[\text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \dots, \text{head}_h) W^O\]
\[\text{head}_i = \text{Attention}(Q W_i^Q, K W_i^K, V W_i^V)\]
Le Tre Famiglie di Architetture Transformer
Dall'architettura originaria sono derivate tre varianti specializzate per compiti differenti:
1. Encoder-only (es. BERT, RoBERTa)
- Workflow: Input \(\to\) Encoder Blocks \(\to\) Rappresentazione Bidirezionale \(\to\) Predizione.
- Caratteristiche: Ogni token ha visibilità completa su tutti i token a destra e sinistra.
- Ideale per: Classificazione testi, Named Entity Recognition (NER), Sentiment Analysis, ricerca semantica vettoriale.
2. Decoder-only (es. GPT-2, Llama, Mistral)
- Workflow: Input \(\to\) Masked Causal Attention \(\to\) Decoder Blocks \(\to\) Next-Token Prediction.
- Caratteristiche: I token possono prestare attenzione alla posizione corrente e ai token precedenti (mascheramento causale triangolare inferiore).
- Ideale per: Generazione di codice, Large Language Model conversazionali, ragionamento autoregressivo.
3. Encoder-Decoder (es. T5, BART)
- Workflow: Input \(\to\) Encoder Bidirezionale \(\to\) Cross-Attention \(\to\) Decoder Autoregressivo \(\to\) Sequenza Target.
- Ideale per: Traduzione automatica multilingue, riassunti astrattivi, compiti sequence-to-sequence generici.
Implementazione Minimale di Self-Attention in PyTorch
import torch
import torch.nn as nn
import math

class ScaledDotProductAttention(nn.Module):
    def __init__(self, d_k):
        super().__init__()
        self.scale = 1.0 / math.sqrt(d_k)

    def forward(self, Q, K, V, mask=None):
        # Q, K, V: [batch_size, num_heads, seq_len, d_k]
        scores = torch.matmul(Q, K.transpose(-2, -1)) * self.scale

        if mask is not None:
            # Applicazione maschera causale (-inf) per bloccare token futuri
            scores = scores.masked_fill(mask == 0, -1e9)

        attn_weights = torch.softmax(scores, dim=-1)
        output = torch.matmul(attn_weights, V)
        return output, attn_weights

# Verifica numerica
batch_size, seq_len, d_k = 2, 4, 64
Q = torch.randn(batch_size, 1, seq_len, d_k)
K = torch.randn(batch_size, 1, seq_len, d_k)
V = torch.randn(batch_size, 1, seq_len, d_k)

attention_layer = ScaledDotProductAttention(d_k)
out, weights = attention_layer(Q, K, V)

print(f"Dimensioni Output Attenzione: {out.shape}")
print(f"Dimensioni Matrice dei Pesi:  {weights.shape}")
print(f"Somma pesi prima riga:       {weights[0, 0, 0].sum().item():.4f}")
Conclusioni
I Transformer hanno ridefinito le frontiere dell'intelligenza artificiale moderna. Tuttavia, l'addestramento e l'adattamento di modelli con decine di miliardi di parametri pongono sfide di memoria formidabili.
La lezione finale introduce il Parameter-Efficient Fine-Tuning (PEFT) e mostra come LoRA e QLoRA riducano i parametri addestrabili e la memoria della base, senza trasformare le stime teoriche in promesse hardware.
Verifica se il concetto è passato
Perché il prodotto QKᵀ viene diviso per la radice di d_k prima della Softmax?
Controlla la risposta
Per evitare valori troppo grandi che saturano la Softmax e producono gradienti molto piccoli, rendendo l'ottimizzazione instabile.
Domande frequenti
Perché i Transformer hanno avuto successo rispetto alle RNN?
Nelle RNN ogni stato dipende dal precedente, limitando la parallelizzazione lungo la sequenza. I Transformer permettono calcoli paralleli sulle posizioni durante il training e sul prompt disponibile; per generare testo autoregressivo restano dipendenze tra token successivi. Le RNN restano utili in altri contesti.
Cosa rappresentano Query (Q), Key (K) e Value (V) nell'attenzione?
Query (Q) rappresenta ciò che un token sta cercando nel contesto; Key (K) rappresenta l'etichetta o il profilo identificativo di ciascun token; Value (V) è il contenuto informativo effettivo che viene pesato e sommato in base all'affinità calcolata tra Query e Key.
Perché nella formula dell'attenzione si divide per la radice quadrata di d_k?
Perché per dimensioni vettoriali elevate, il prodotto scalare Q*K^T assume valori numerici molto grandi, spingendo la funzione Softmax in regioni asintotiche con gradienti infinitesimali (piatti). La scala 1/sqrt(d_k) compensa questa crescita; la varianza unitaria è una motivazione basata su ipotesi di componenti indipendenti, centrate e con varianza unitaria, non una garanzia durante il training.
Qual è la differenza fondamentale tra BERT (Encoder-only) e GPT (Decoder-only)?
BERT usa l'attenzione bidirezionale completa (ogni parola può guardare sia a sinistra che a destra) ed è ideale per la comprensione e classificazione del testo. GPT usa l'attenzione causale mascherata (ogni posizione può guardare a se stessa e a quelle precedenti) ed è progettato per la generazione autoregressiva del token successivo.
A cosa servono le connessioni residue (Residual Connections) e la Layer Normalization?
Le connessioni residue (skip connections: x + Sublayer(x)) offrono percorsi più diretti al gradiente e facilitano l'addestramento di reti profonde, senza garantirne la stabilità, mentre la Layer Normalization stabilizza la distribuzione statistica delle attivazioni.
Fonti e approfondimenti
Continua da qui

Reti Neurali Profonde: Forward Pass, Backpropagation e Funzioni di Attivazione
Architettura delle reti neurali: calcolo vettoriale del forward pass, non-linearità con ReLU, classificazione Softmax, Adam e Backpropagation.

Fine-Tuning efficiente: LoRA e QLoRA senza miti sulla memoria
Come adattare un LLM con LoRA e QLoRA: parametri addestrabili, quantizzazione, memoria reale e configurazione PEFT senza promesse magiche.

Mappa del Machine Learning: guida completa dai fondamenti alle architetture moderne
Guida esaustiva al Machine Learning: definizioni formali, tassonomia completa, paradigmi di apprendimento e workflow operativo end-to-end.