Cosa saprai fare
- Distinguere full fine-tuning, LoRA e QLoRA
- Calcolare i parametri addestrabili di un adapter LoRA
- Stimare i principali componenti del consumo di memoria
Prima di iniziare
- Lezione 10: Transformer
- PyTorch e nozioni di memoria GPU
TLDR
- Il full fine-tuning aggiorna tutti i pesi e deve gestire anche gradienti, stati dell'optimizer e attivazioni.
- LoRA congela il modello base e addestra matrici a basso rango; il numero reale di parametri dipende dal rango e dai moduli scelti.
- QLoRA conserva la base quantizzata a 4 bit e addestra adapter LoRA, riducendo la memoria senza fissare una soglia hardware universale.
- La pratica corretta è partire da un modello piccolo, misurare il picco di memoria e aumentare la scala solo dopo una prova completa.
Il problema giusto: cosa occupa davvero la memoria
Un Large Language Model contiene miliardi di parametri, ma durante l'addestramento la memoria non è occupata soltanto dai pesi. Il full fine-tuning aggiorna ogni parametro e deve conservare diversi elementi:
- i pesi del modello;
- i gradienti;
- gli stati dell'optimizer;
- le attivazioni necessarie alla backpropagation;
- buffer temporanei usati dal runtime.
Per \(P\) parametri, il solo spazio ideale dei pesi è:
\[M_{pesi} = P \cdot \frac{b}{8}\]
dove \(b\) è il numero di bit per parametro. Per esempio, \(70\) miliardi di pesi a \(16\) bit richiedono idealmente circa \(140\) GB solo per essere rappresentati. Non è una stima del training completo: attivazioni, optimizer, frammentazione, quantizzazione e distribuzione su più dispositivi cambiano il fabbisogno reale.
Questa distinzione evita il primo errore comune: ricavare da un singolo numero la GPU necessaria.
LoRA: addestrare una correzione a basso rango
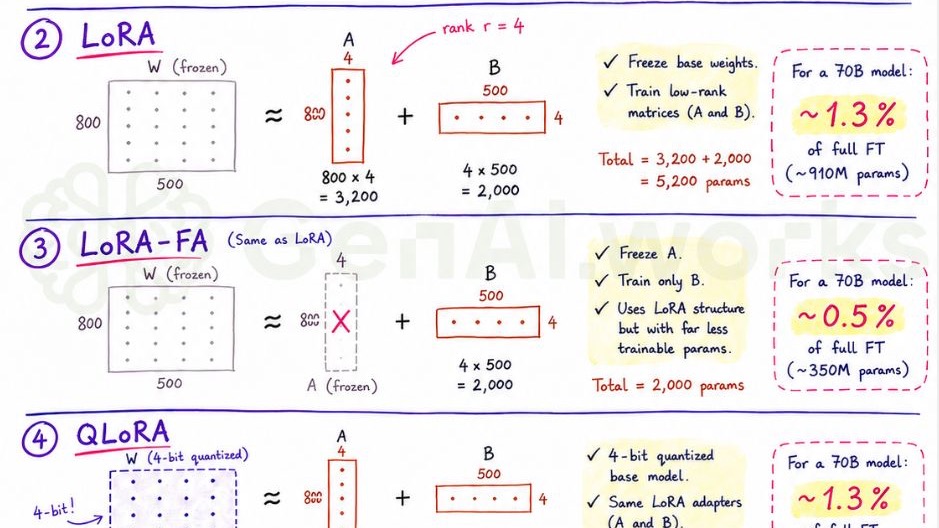
LoRA congela una matrice pre-addestrata \(W_0\) e impara una correzione \(\Delta W\) come prodotto di due matrici più piccole:
\[W' = W_0 + \Delta W = W_0 + BA\]
Se \(W_0 \in \mathbb{R}^{d_{out} \times d_{in}}\) e il rango scelto è \(r\), allora:
\[A \in \mathbb{R}^{r \times d_{in}}, \qquad B \in \mathbb{R}^{d_{out} \times r}\]
I parametri addestrabili dell'adapter sono:
\[N_{LoRA} = r(d_{in} + d_{out})\]
Un esempio calcolabile
Per una proiezione \(4096 \times 4096\) e rango \(r=8\):
\[N_{LoRA} = 8(4096 + 4096) = 65.536\]
La matrice completa contiene invece:
\[4096 \cdot 4096 = 16.777.216\]
In questo singolo layer l'adapter equivale a circa lo \(0,39\%\) dei pesi della matrice. La percentuale dell'intero modello, però, dipende da quanti e quali moduli ricevono LoRA. Non esiste quindi un valore universale come “LoRA usa sempre l'1%”.
Rango e moduli target
Due decisioni controllano gran parte del compromesso:
- rango
r: valori maggiori aumentano capacità e parametri addestrabili; - moduli target: applicare LoRA solo alle proiezioni query/value costa meno che applicarlo a tutti i layer lineari.
La configurazione va scelta come un iperparametro e validata sul task, non dedotta soltanto dalla dimensione nominale del modello.
QLoRA: base quantizzata, adapter addestrabili
QLoRA combina gli adapter LoRA con un modello base congelato e quantizzato a 4 bit. Nel metodo originale sono centrali il formato NF4, la doppia quantizzazione e tecniche per gestire i picchi di memoria.
Il vantaggio principale è chiaro: i pesi congelati occupano molto meno spazio rispetto alla rappresentazione a 16 bit. Ma “4 bit” non significa che l'intero processo usi esattamente mezzo byte per parametro. Durante il training restano:
- adapter e gradienti in precisione più alta;
- attivazioni, che crescono con batch e lunghezza delle sequenze;
- stati dell'optimizer degli adapter;
- cache, buffer e overhead del framework.
Per questo una stima teorica di circa \(35\) GB per i soli pesi 4-bit di un modello 70B non implica che quel modello possa essere addestrato entro 35 GB di VRAM, né che una specifica GPU consumer sia sufficiente.
Confronto operativo
| Metodo | Pesi base | Parametri aggiornati | Vantaggio principale | Vincolo da controllare |
|---|---|---|---|---|
| Full fine-tuning | Precisione di training | Tutti | Massima libertà di aggiornamento | Memoria e costo elevati |
| LoRA | Congelati, spesso 16 bit | Solo adapter | Pochi parametri e checkpoint piccoli | La base resta in memoria |
| QLoRA | Congelati, 4 bit | Solo adapter | Riduce anche la memoria della base | Supporto hardware e overhead reale |
LoRA e QLoRA non sono scorciatoie automatiche verso un risultato migliore. Sono strumenti per rendere sostenibile un esperimento che deve comunque avere dati, baseline e metriche adeguati.
Configurazione PEFT leggibile e verificabile
L'esempio seguente mostra i passaggi essenziali. Sostituisci model_id con un modello causal language compatibile con licenza, hardware e librerie installate.
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training

model_id = "your-org/your-causal-lm"

quantization = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=quantization,
    device_map="auto",
)
model = prepare_model_for_kbit_training(model)

lora = LoraConfig(
    r=8,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules="all-linear",
)

model = get_peft_model(model, lora)
model.print_trainable_parameters()
target_modules="all-linear" segue l'impostazione QLoRA proposta dalla documentazione PEFT per applicare gli adapter ai layer lineari. Alcune architetture o versioni delle librerie richiedono nomi espliciti: controlla sempre model.named_modules() e la documentazione del modello.
Il valore stampato da print_trainable_parameters() è il numero da riportare nel tuo esperimento. È più affidabile di una percentuale copiata da un'altra architettura.
Procedura consigliata per il primo esperimento
- Scegli una baseline. Valuta il modello base su esempi che rappresentano il task reale.
- Pulisci e separa i dati. Mantieni training e validation distinti e controlla duplicati o contaminazioni.
- Parti piccolo. Usa un modello e una lunghezza di contesto che lascino margine alla memoria disponibile.
- Misura il picco. Registra memoria massima, tempo per step e throughput durante una breve esecuzione completa.
- Cambia una variabile alla volta. Rango, moduli target, learning rate, batch e contesto hanno effetti diversi.
- Confronta la qualità. Valuta adapter e modello base con le stesse metriche e gli stessi esempi.
- Salva adapter e configurazione. Un checkpoint PEFT è utile solo se è riproducibile con la corretta base.
Checklist prima del training
- Il modello è utilizzabile secondo licenza e termini di accesso?
- Il backend di quantizzazione supporta davvero la GPU disponibile?
- La precisione
bfloat16è supportata oppure servefloat16? - Il validation set misura il comportamento che vuoi migliorare?
- Hai registrato versione del modello, dataset, seed e configurazione PEFT?
Errori frequenti
Confondere pesi e memoria totale. Il peso teorico del modello non comprende l'intero training.
Riutilizzare una percentuale LoRA. Il conteggio cambia con rango, dimensioni e moduli target.
Partire subito da 70B. Un errore nella pipeline costa molto meno se emerge prima su un modello piccolo.
Valutare soltanto la loss. La loss di validation è utile, ma non sostituisce metriche e test legati al compito.
Dimenticare la baseline. Senza il risultato del modello base non puoi sapere se l'adapter ha davvero migliorato qualcosa.
Conclusioni
LoRA riduce il numero di parametri aggiornati; QLoRA riduce anche la memoria dei pesi congelati. Il risparmio è concreto, ma non elimina i costi di attivazioni, contesto, optimizer e runtime. La competenza utile non consiste nel ricordare una cifra di VRAM: consiste nel saper calcolare gli adapter, costruire una baseline e misurare il proprio esperimento.
Questa lezione conclude il percorso. Da qui puoi tornare all'indice del corso per ripassare i prerequisiti oppure scegliere un piccolo progetto e documentare dati, metriche, memoria e risultati.
Verifica se il concetto è passato
QLoRA rende automaticamente addestrabile qualunque modello 70B su un normale laptop?
Controlla la risposta
No. Riduce la memoria occupata dai pesi congelati, ma attivazioni, contesto, batch, optimizer e runtime richiedono comunque hardware e configurazioni adeguate.
FAQ
Perché il full fine-tuning consuma molto più spazio dei soli pesi del modello?
Durante il training servono anche gradienti, stati dell'optimizer, attivazioni e buffer temporanei. Precisione numerica, optimizer, batch, lunghezza del contesto, checkpointing e strategia distribuita cambiano il totale.
Come si calcolano i parametri di un adapter LoRA?
Per una matrice d_out per d_in e rango r, le due matrici LoRA contengono r(d_in + d_out) parametri. Il totale del modello è la somma sui moduli a cui vengono applicati gli adapter.
Qual è la differenza fondamentale tra LoRA e QLoRA?
Entrambe addestrano adapter a basso rango. QLoRA, in più, mantiene i pesi congelati del modello base in formato quantizzato a 4 bit durante il fine-tuning.
QLoRA garantisce la stessa qualità del full fine-tuning?
No. È un metodo molto efficace, ma la qualità dipende da modello, dati, task, moduli target e iperparametri. Il confronto va misurato su un validation set coerente con l'uso reale.
Da quale configurazione conviene partire?
Da un modello compatibile con l'hardware, un dataset piccolo ma pulito, rango contenuto e una baseline valutata prima del training. Solo dopo conviene ampliare moduli target, contesto o dimensione del modello.
Fonti
Continua da qui
Architettura Transformer e Meccanismo di Attenzione: Guida Completa agli LLM
Come funzionano i Transformer: limiti di RNN/LSTM, Positional Encoding, Scaled Dot-Product Attention, Multi-Head Attention ed Encoder-Decoder.
Mappa del Machine Learning: guida completa dai fondamenti alle architetture moderne
Guida esaustiva al Machine Learning: definizioni formali, tassonomia completa, paradigmi di apprendimento e workflow operativo end-to-end.
Reti Neurali Profonde: Forward Pass, Backpropagation e Funzioni di Attivazione
Architettura delle reti neurali: calcolo vettoriale del forward pass, non-linearità con ReLU, classificazione Softmax, Adam e Backpropagation.