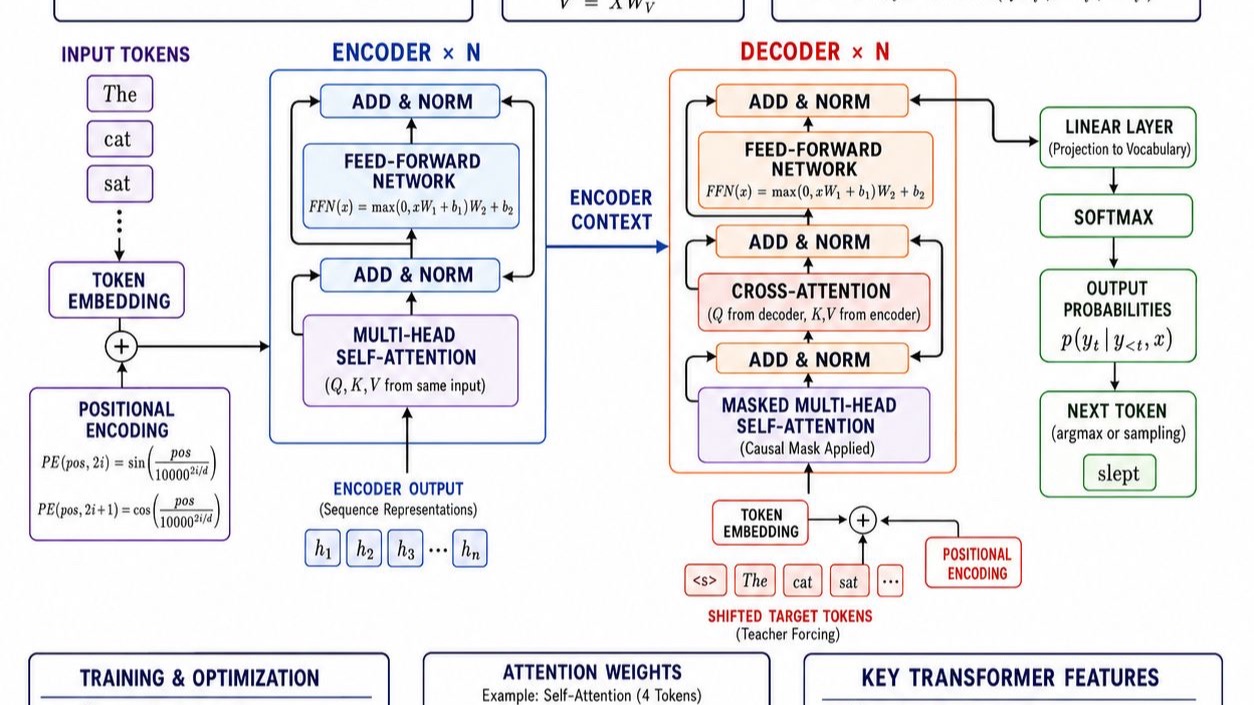
Architettura Transformer e Meccanismo di Attenzione: Guida Completa agli LLM
Come funzionano i Transformer: limiti di RNN/LSTM, Positional Encoding, Scaled Dot-Product Attention, Multi-Head Attention ed Encoder-Decoder.
LeggiGuide, analisi e storie Able2Code su Deep learning: 5 articoli con spiegazioni tecniche e difese pratiche.
Come funzionano i Transformer: limiti di RNN/LSTM, Positional Encoding, Scaled Dot-Product Attention, Multi-Head Attention ed Encoder-Decoder.
Leggi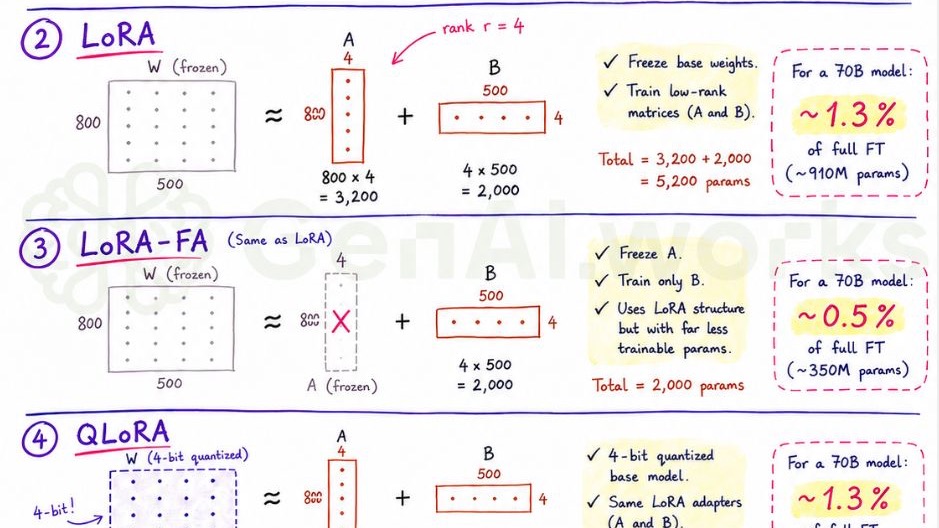
Come adattare un LLM con LoRA e QLoRA: parametri addestrabili, quantizzazione, memoria reale e configurazione PEFT senza promesse magiche.
Leggi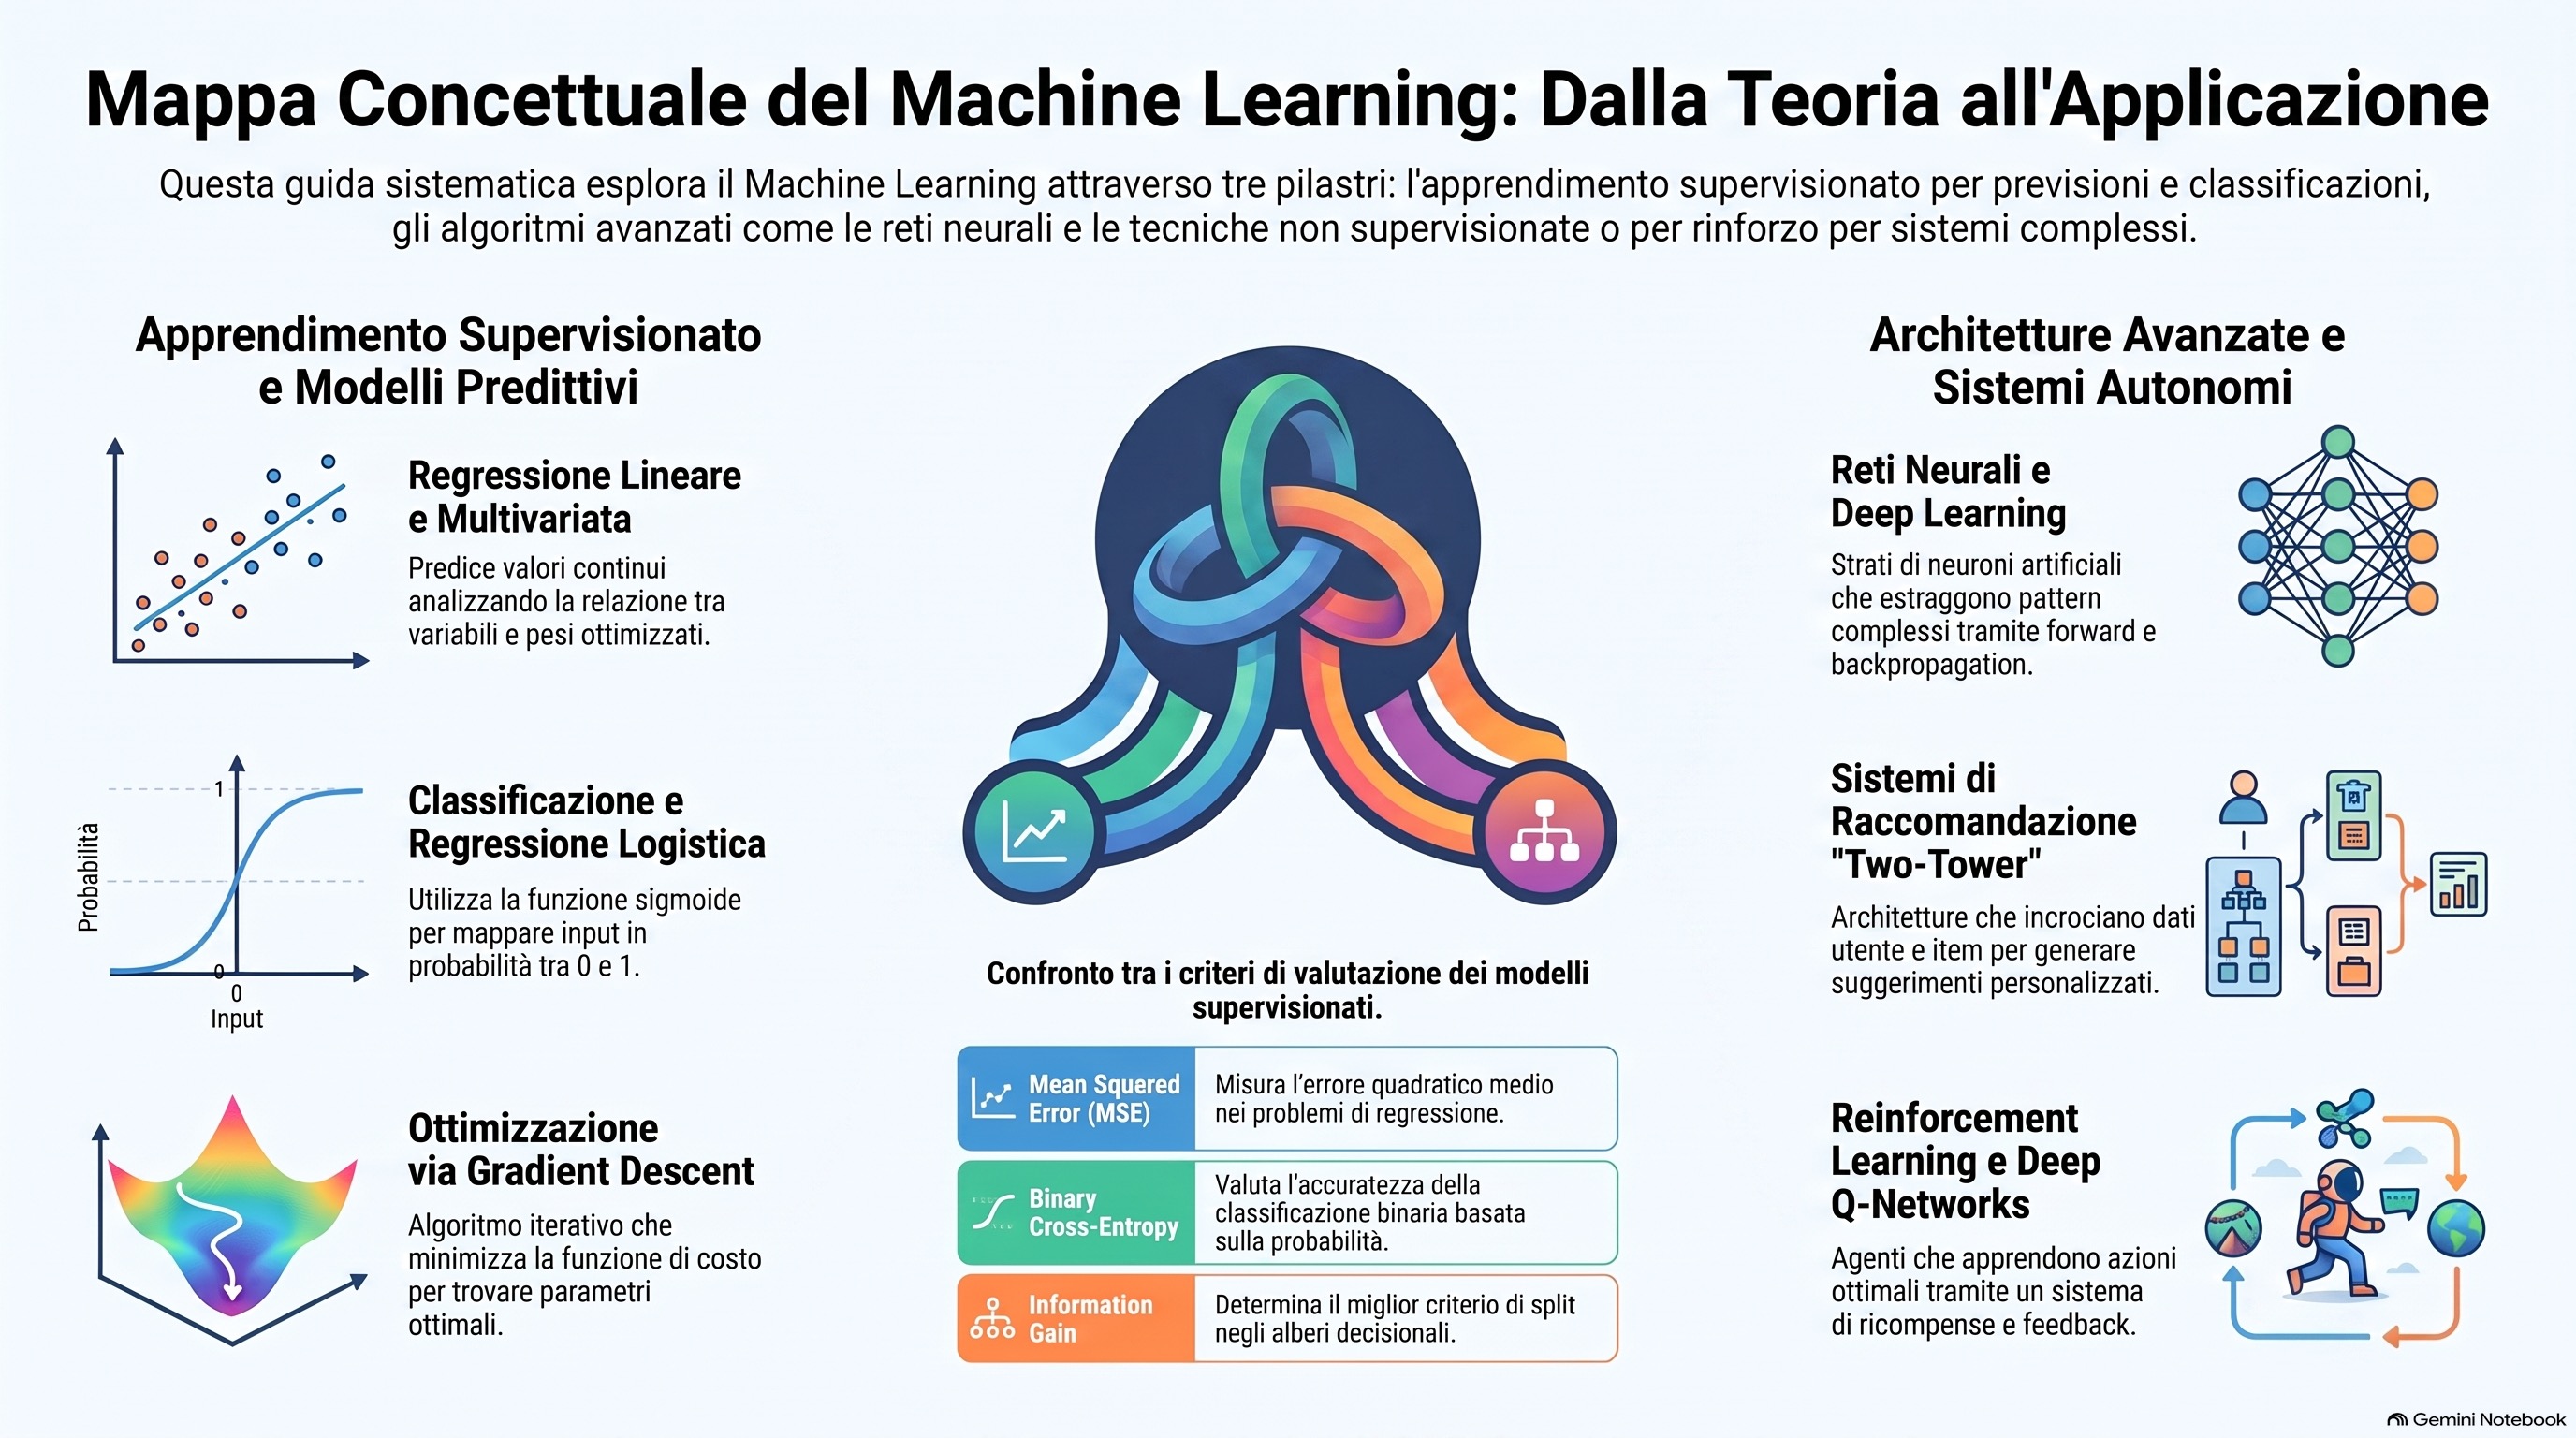
Guida esaustiva al Machine Learning: definizioni formali, tassonomia completa, paradigmi di apprendimento e workflow operativo end-to-end.
Leggi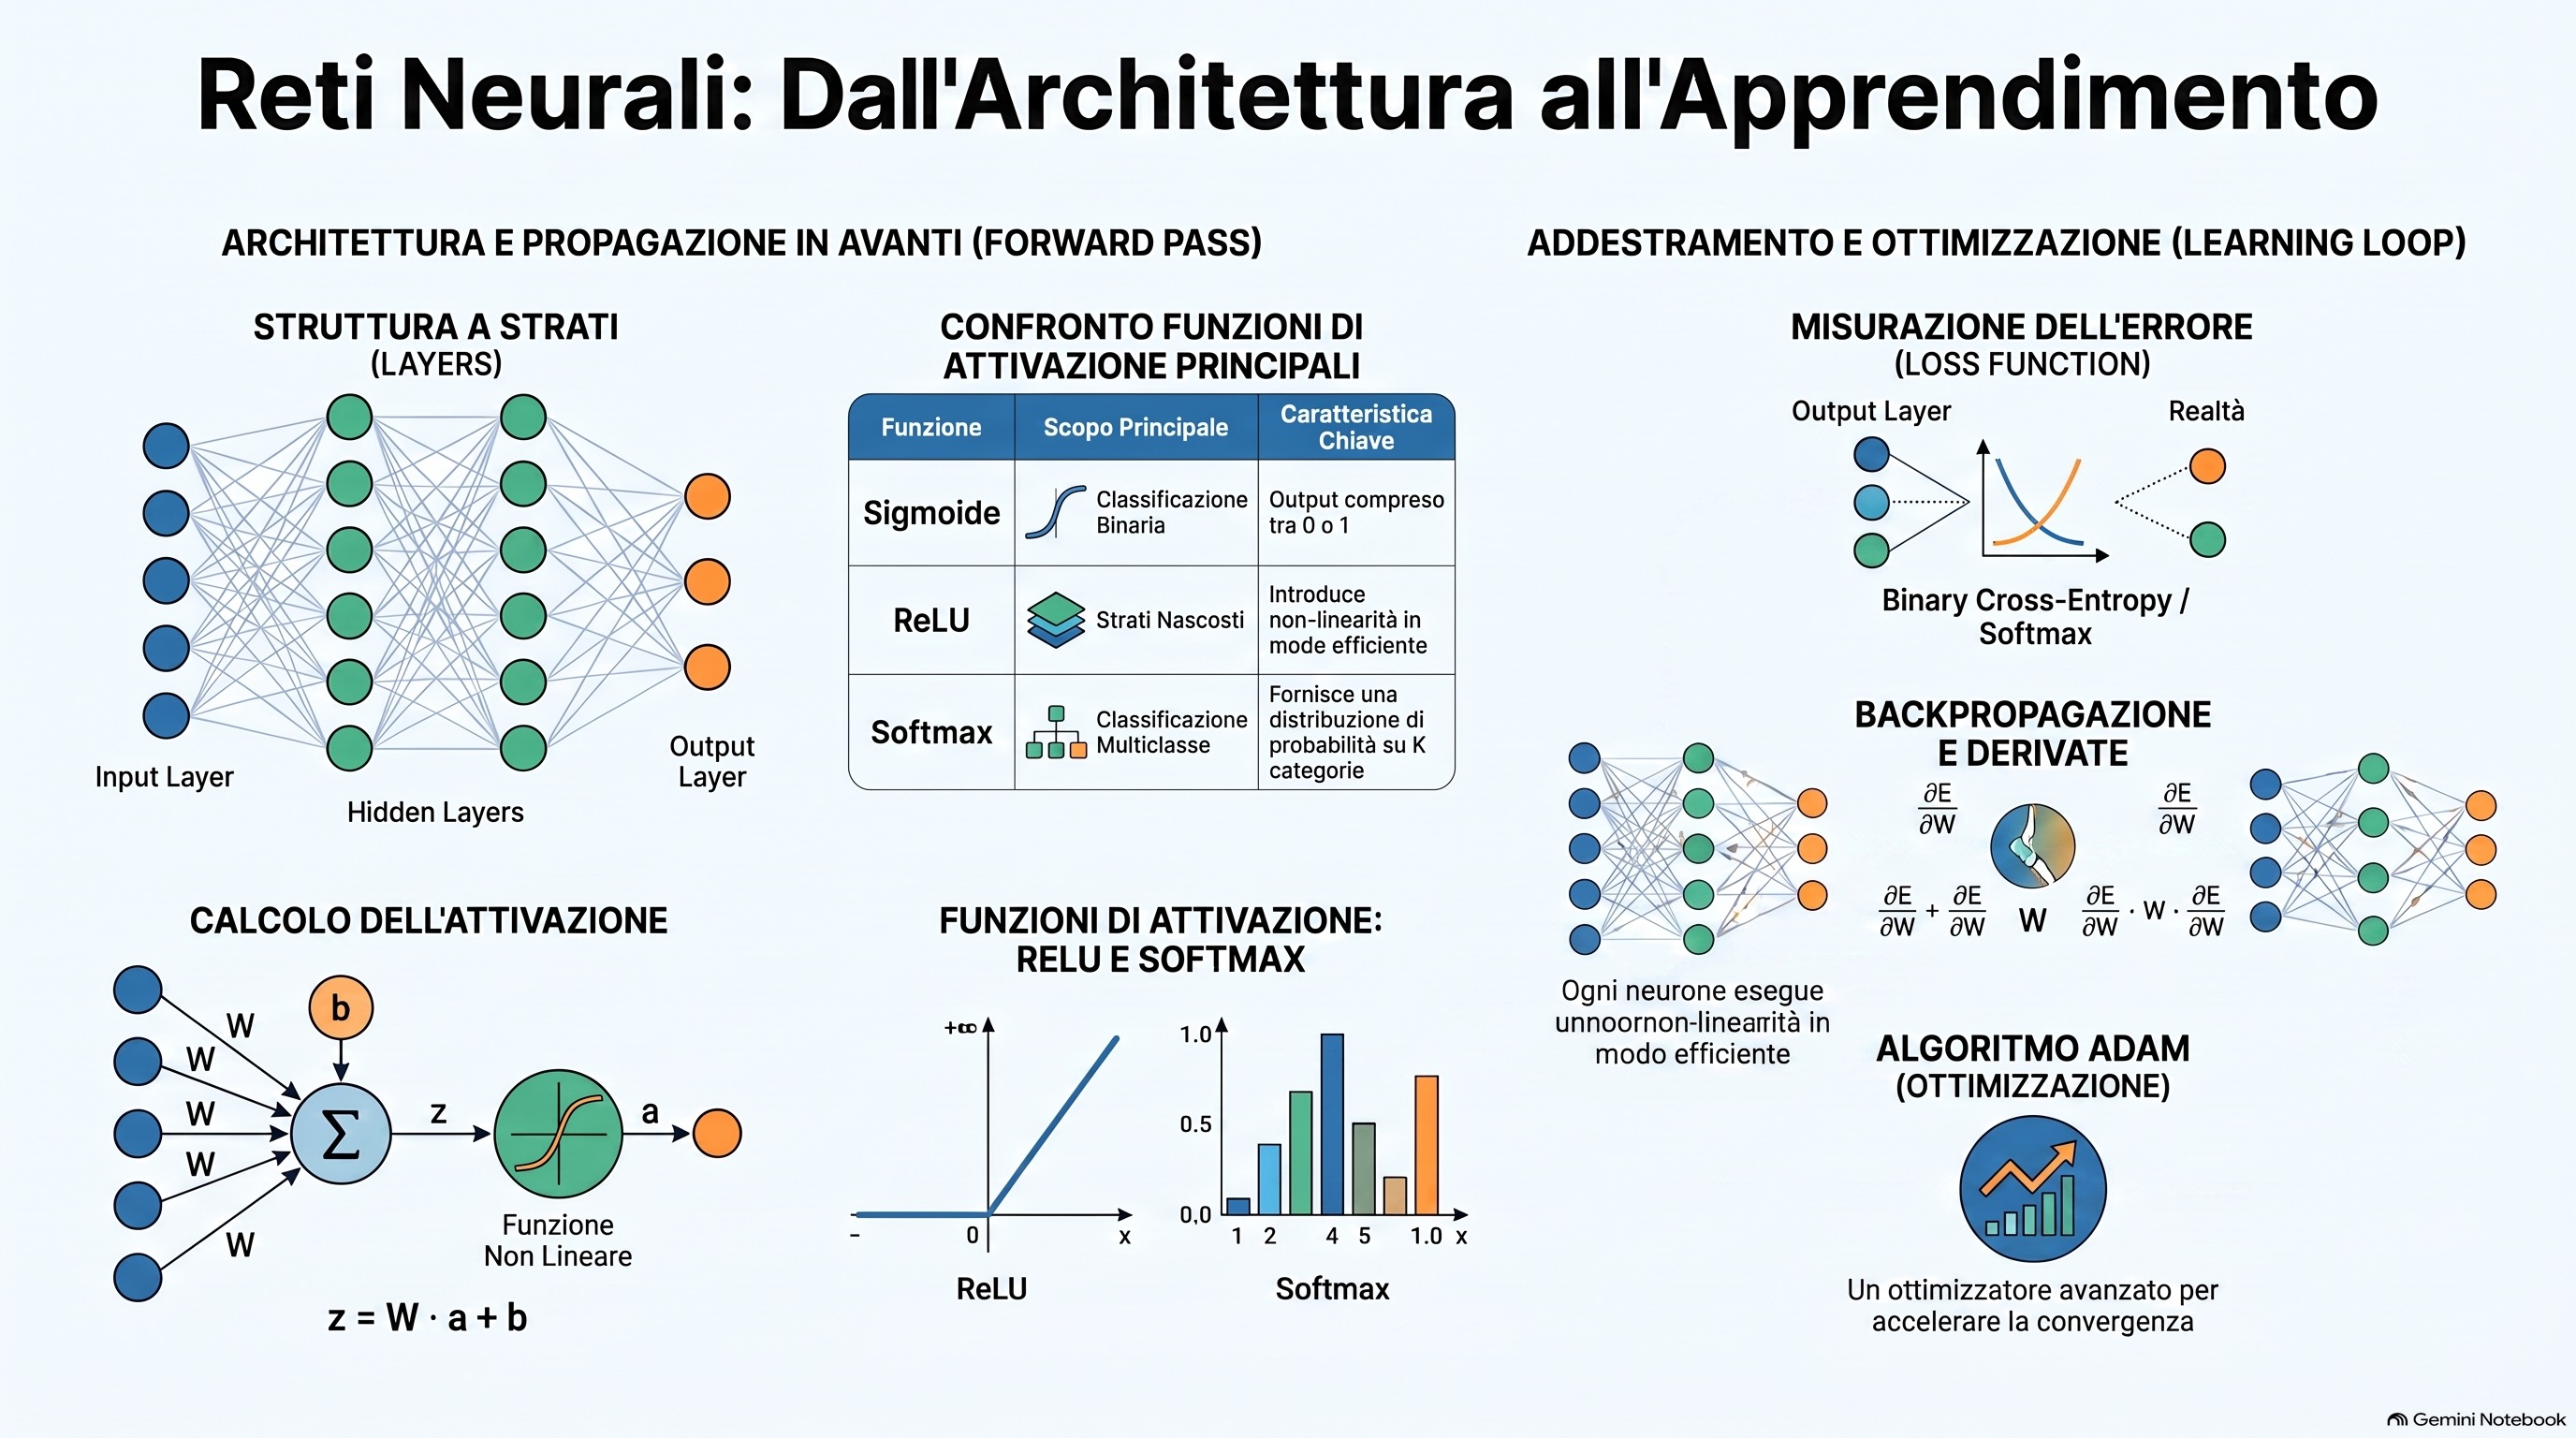
Architettura delle reti neurali: calcolo vettoriale del forward pass, non-linearità con ReLU, classificazione Softmax, Adam e Backpropagation.
Leggi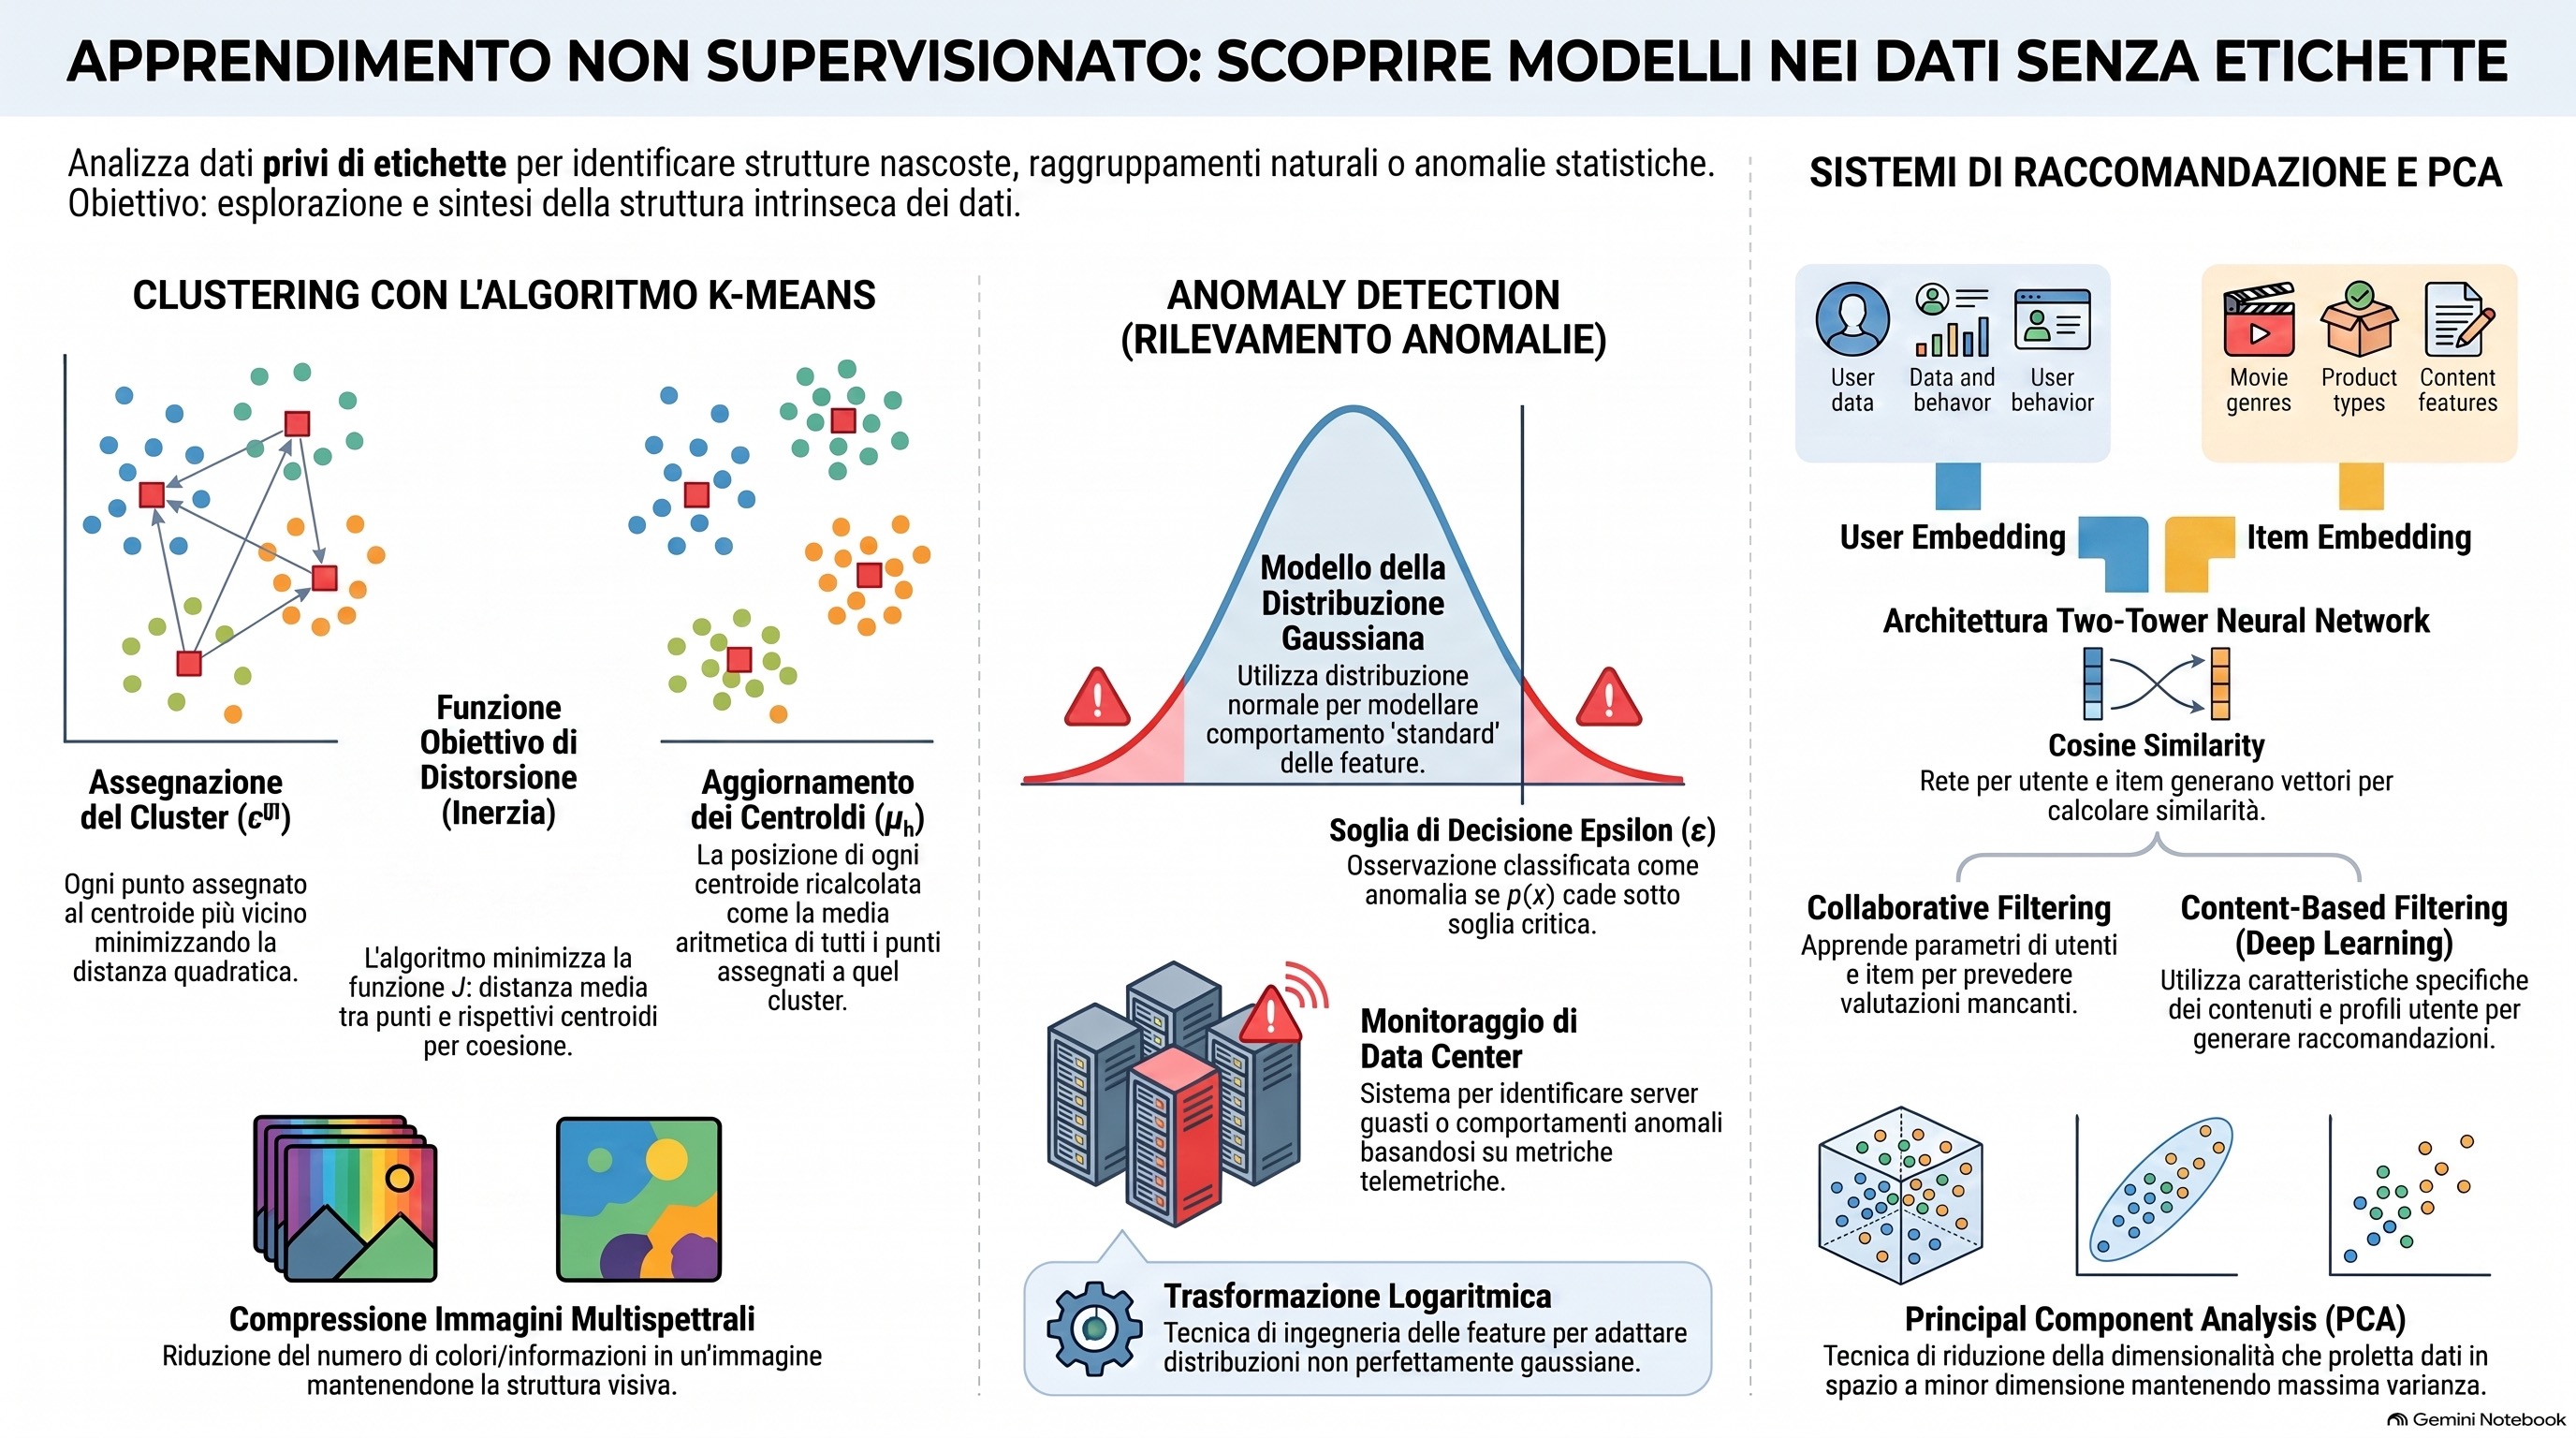
Come funzionano i sistemi di raccomandazione moderni: Collaborative Filtering, fattorizzazione matriciale e Two-Tower Deep Learning per Retrieval e Ranking.
Leggi