
In questo articolo
Cosa saprai fare
- Capire il filtraggio collaborativo
- Leggere una architettura Two-Tower
- Distinguere retrieval e ranking
Prima di iniziare
- Lezione 5: reti neurali
- Prodotto scalare e embedding
In breve
- I sistemi di raccomandazione trasformano matrici sparse di valutazioni storiche in predizioni accurate sui gusti futuri degli utenti.
- Il Filtraggio Collaborativo apprende simultaneamente i vettori dei gusti utente e le feature latenti dei contenuti tramite discesa del gradiente.
- La normalizzazione delle medie risolve il problema dell'avvio a freddo per nuovi utenti privi di storico.
- L'architettura Two-Tower proietta utenti e contenuti in uno spazio vettoriale comune, abilitando pipeline industriali di Retrieval e Ranking su milioni di item.
Il Motore dell'Economia Digitale
I Sistemi di Raccomandazione (Recommender Systems) alimentano le più grandi piattaforme web mondiali: dallo streaming video (YouTube, Netflix) all'e-commerce (Amazon) e alle piattaforme musicali (Spotify).
La sfida ingegneristica è enorme: dato un catalogo di centinaia di milioni di contenuti e centinaia di milioni di utenti, come possiamo selezionare in meno di 10 millisecondi la manciata esatta di articoli che un singolo utente apprezzerà maggiormente?
                     Catalogo Massivo (100.000.000 di Contenuti)
                                         │
                                         ▼
                 [ FASE 1: RETRIEVAL / CANDIDATE GENERATION ]
                   Ricerca Vettoriale Approssimata (k-NN / Faiss)
                   Tempo: < 5ms  ──►  Top 500 Candidati
                                         │
                                         ▼
                 [ FASE 2: NEURAL SCORING & RANKING ]
                   Rete Neurale Profonda con Feature di Contesto
                   Tempo: < 10ms ──►  Top 10 Selezionati per il Feed
Filtraggio Collaborativo e Apprendimento Simultaneo
Nel Filtraggio Collaborativo (Collaborative Filtering), il sistema non richiede metadati manuali sui film (come genere o regista): apprende i gusti e le proprietà unicamente analizzando la matrice sparsa delle interazioni storiche Utenti \(\times\) Item.
Definiamo:
- \(r(i, j) = 1\) se l'utente \(j\) ha valutato l'item \(i\);
- \(y^{(i, j)}\) il rating numerico effettivo assegnato.
Ogni utente \(j\) è descritto da un vettore di parametri \(\mathbf{w}^{(j)} \in \mathbb{R}^n\) e da un bias scalare \(b^{(j)}\); ogni item \(i\) è descritto da un vettore di feature latenti \(\mathbf{x}^{(i)} \in \mathbb{R}^n\).
La predizione per la coppia \((i, j)\) è definita come: \[\hat{y}^{(i, j)} = \mathbf{w}^{(j)} \cdot \mathbf{x}^{(i)} + b^{(j)}\]
Funzione di Costo Globale Regolarizzata
L'algoritmo minimizza la discrepanza quadratica sulle sole coppie con rating noto (\(r(i,j)=1\)), apprendendo contemporaneamente \(\mathbf{w}, \mathbf{b}\) e \(\mathbf{x}\) tramite discesa del gradiente:
\[J(\mathbf{w}, \mathbf{b}, \mathbf{x}) = \frac{1}{2} \sum_{(i,j): r(i,j)=1} \left( \mathbf{w}^{(j)} \cdot \mathbf{x}^{(i)} + b^{(j)} - y^{(i,j)} \right)^2 + \frac{\lambda}{2}\sum_{j=1}^{n_u}\sum_{k=1}^n (w_k^{(j)})^2 + \frac{\lambda}{2}\sum_{i=1}^{n_m}\sum_{k=1}^n (x_k^{(i)})^2\]
Architettura Two-Tower Deep Learning
Quando il sistema deve integrare feature eterogenee (dati anagrafici, storico di visualizzazione recente, ora del giorno, testo descrittivo del prodotto), si adotta l'architettura Two-Tower Neural Network.
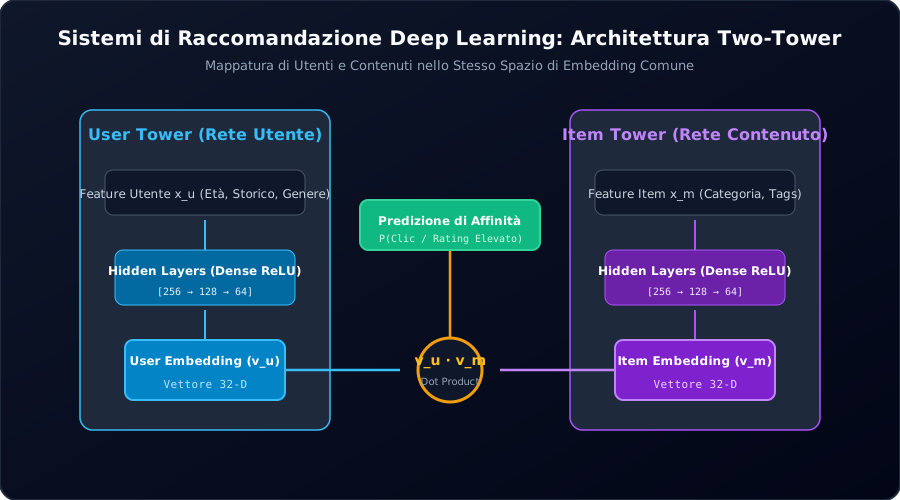
Struttura delle Due Torri
- User Tower (\(\text{Torre Utente}\)): Rete neurale profonda che riceve in input l'identificativo utente, le feature demografiche, gli ultimi 20 video guardati e le query recenti, proiettando il tutto in un vettore latente compatto \(\mathbf{v}_u \in \mathbb{R}^d\) (es. \(d=64\)).
- Item Tower (\(\text{Torre Contenuto}\)): Rete neurale parallela che elabora l'ID del video, il titolo (tramite embedding linguistico), la categoria e le statistiche di gradimento, proiettando il contenuto in un vettore latente \(\mathbf{v}_m \in \mathbb{R}^d\).
Calcolo di Affinità e Retrieval Vettoriale
Nello spazio di embedding a \(d\) dimensioni, l'affinità tra l'utente \(u\) e il candidato \(m\) si riduce a un velocissimo prodotto scalare:
\[\text{Affinità}(u, m) = \mathbf{v}_u \cdot \mathbf{v}_m = \sum_{k=1}^d v_u^{(k)} v_m^{(k)}\]
I vettori degli item \(\mathbf{v}_m\) possono essere pre-calcolati e inseriti in un indice di ricerca approssimata. HNSW (Hierarchical Navigable Small World) usa un grafo gerarchico, non un albero. La latenza va misurata: dipende da hardware, dimensione dei vettori, dimensione del catalogo, recall richiesta e parametri dell'indice.
Laboratorio Pratico: Collaborative Filtering in TensorFlow con GradientTape
import tensorflow as tf
import numpy as np

# 1. Configurazione dimensioni matrice (10 utenti, 15 film, spazio latente d=4)
num_users = 10
num_movies = 15
d_features = 4

# Inizializzazione pesi utente e feature film casuali
W_init = tf.random.normal((num_users, d_features), dtype=tf.float32)
X_init = tf.random.normal((num_movies, d_features), dtype=tf.float32)
b_init = tf.zeros((1, num_users), dtype=tf.float32)

W = tf.Variable(W_init)
X = tf.Variable(X_init)
b = tf.Variable(b_init)

# Matrice fittizia di Rating (15 film x 10 utenti) e Maschera di presenza r
Y = tf.random.uniform((num_movies, num_users), minval=1.0, maxval=5.0, dtype=tf.float32)
R = tf.cast(tf.random.uniform((num_movies, num_users)) > 0.4, tf.float32)

# 2. Funzione di Costo con TensorFlow
def cofi_cost_func(X, W, b, Y, R, lambda_reg=0.1):
    # Predizione matriciale: (movies x users)
    preds = tf.matmul(X, tf.transpose(W)) + b
    err = (preds - Y) * R
    cost = 0.5 * tf.reduce_sum(tf.square(err))

    # Termini di regolarizzazione L2
    reg = 0.5 * lambda_reg * (tf.reduce_sum(tf.square(W)) + tf.reduce_sum(tf.square(X)))
    return cost + reg

# 3. Ottimizzazione con Adam e GradientTape
optimizer = tf.keras.optimizers.Adam(learning_rate=0.1)

print("Addestramento del modello di Collaborative Filtering...")
for iter in range(201):
    with tf.GradientTape() as tape:
        cost = cofi_cost_func(X, W, b, Y, R, lambda_reg=0.01)

    grads = tape.gradient(cost, [X, W, b])
    optimizer.apply_gradients(zip(grads, [X, W, b]))

    if iter % 50 == 0:
        print(f"Iterazione {iter:3d}: Costo CoFi = {cost.numpy():.4f}")

# 4. Predizione finale per l'utente 0
predicted_ratings = (tf.matmul(X, tf.transpose(W)) + b).numpy()
print(f"\nValutazioni previste per l'Utente 0:\n{predicted_ratings[:, 0].round(2)}")
Conclusioni
Dai modelli a fattorizzazione matriciale alle architetture Two-Tower distribuite, i sistemi di raccomandazione uniscono algebra lineare, deep learning e ingegneria di ricerca vettoriale su larga scala.
La lezione successiva introduce un paradigma diverso: il Reinforcement Learning, con processi decisionali di Markov, equazione di Bellman e Deep Q-Networks.
Verifica se il concetto è passato
Perché in produzione si separano spesso retrieval e ranking?
Controlla la risposta
Il retrieval restringe rapidamente milioni di candidati; il ranking usa poi un modello più costoso su un insieme piccolo e gestibile.
Domande frequenti
Come apprende il Filtraggio Collaborativo senza etichettatura manuale preventiva?
Il modello modella il rating predetto come prodotto scalare w_j * x_i + b_j. La funzione di costo penalizza l'errore rispetto alle sole valutazioni storiche effettivamente espresse, forzando la discesa del gradiente ad aggiustare simultaneamente sia i vettori di preferenza w degli utenti sia le caratteristiche latenti x degli articoli.
Perché è fondamentale la normalizzazione delle medie (Mean Normalization)?
Nel modello didattico, con parametri del nuovo utente inizializzati a zero, riaggiungere la media dei rating degli item fornisce una baseline. Non risolve il cold start: inizializzazione, regolarizzazione, popolarità e informazioni disponibili sull'utente determinano il comportamento reale.
Come funziona l'architettura Two-Tower Deep Learning?
È composta da due reti neurali parallele separate: la User Tower (che trasforma età, storico, geolocalizzazione dell'utente in un vettore v_u) e la Item Tower (che trasforma genere, testo, tag dell'articolo in un vettore v_m nello stesso spazio a d dimensioni). L'affinità si calcola istantaneamente con un semplice prodotto scalare v_u * v_m.
Qual è la differenza tra la fase di Retrieval e la fase di Ranking?
Il retrieval seleziona un insieme ridotto di candidati dal catalogo, spesso tramite ricerca vettoriale approssimata. Il ranking li ordina con un modello o regole più costosi. Numero di candidati, latenza e risultati mostrati sono scelte di progetto, non costanti dell'architettura.
Cosa si intende per feedback implicito rispetto al feedback esplicito?
Il feedback esplicito è un voto numerico diretto assegnato dall'utente (es. da 1 a 5 stelle). Il feedback implicito deriva dal comportamento naturale dell'utente (click, tempo di permanenza sul video, aggiunta al carrello, skip), fornendo volumi di dati immensamente superiori ma con più rumore statistico.
Fonti e approfondimenti
- Malkov e Yashunin - HNSW graphs
- TensorFlow Recommenders - Retrieval
- Paul Covington et al. - Deep Neural Networks for YouTube Recommendations (RecSys)
- Yehuda Koren et al. - Matrix Factorization Techniques for Recommender Systems (IEEE Computer)
- Google Developers - Recommendation Systems Guide
- TensorFlow Recommenders (TFRS) Documentation
Continua da qui

Mappa del Machine Learning: guida completa dai fondamenti alle architetture moderne
Guida esaustiva al Machine Learning: definizioni formali, tassonomia completa, paradigmi di apprendimento e workflow operativo end-to-end.

Reti Neurali Profonde: Forward Pass, Backpropagation e Funzioni di Attivazione
Architettura delle reti neurali: calcolo vettoriale del forward pass, non-linearità con ReLU, classificazione Softmax, Adam e Backpropagation.

Apprendimento Non Supervisionato: Clustering K-Means, Anomaly Detection e PCA
Estrarre pattern senza etichette: algoritmo K-Means, rilevamento delle anomalie con curve gaussiane e riduzione dimensionale PCA.