
In questo articolo
Cosa saprai fare
- Seguire un forward pass strato per strato
- Capire il ruolo di ReLU, Softmax e logits
- Collegare backpropagation, gradienti e Adam
Prima di iniziare
- Lezione 4: classificazione logistica
- Vettori, matrici e derivate di base
In breve
- Le reti neurali profonde apprendono gerarchie di feature astratte attraverso l'impilamento di strati densi (Dense Layers).
- Senza funzioni di attivazione non lineari (come ReLU), qualsiasi rete profonda collassa matematicamente in una singola regressione lineare.
- La funzione Softmax normalizza i Logits in distribuzioni di probabilità multiclasse: la stabilità numerica richiede l'uso di from_logits=True.
- La Backpropagation applica iterativamente la regola della catena del calcolo differenziale a ritroso su grafi computazionali orientati.
Dai Modelli Lineari alle Architetture Multistrato
Quando la complessità delle relazioni tra i dati supera ciò che una combinazione lineare o un polinomio a mano possono descrivere, entriamo nel dominio del Deep Learning.
Una Rete Neurale Artificiale non impone a priori quali interazioni tra feature siano rilevanti: le apprende autonomamente attraverso una gerarchia di strati astratti interconnessi.

Consideriamo un caso applicativo critico: la gestione intelligente del dispacciamento energetico su reti Smart Grid.
- Strato di Input (\(\mathbf{a}^{[0]} = \mathbf{x}\)): Prezzo orario dell'energia, previsione meteorologica eolica/solare, carico industriale previsto, livello di stoccaggio delle batterie.
- Hidden Layers (\(\mathbf{a}^{[1]}, \mathbf{a}^{[2]}\)): Apprendono correlazioni complesse tra picchi di consumo, profili tariffari e isteresi degli accumulatori.
- Output Layer (\(\mathbf{a}^{[L]}\)): Stima precisa dei megawattora (\(\text{MWh}\)) da dispacciare su ciascuna dorsale della rete.
La Meccanica del Forward Pass (Propagazione in Avanti)
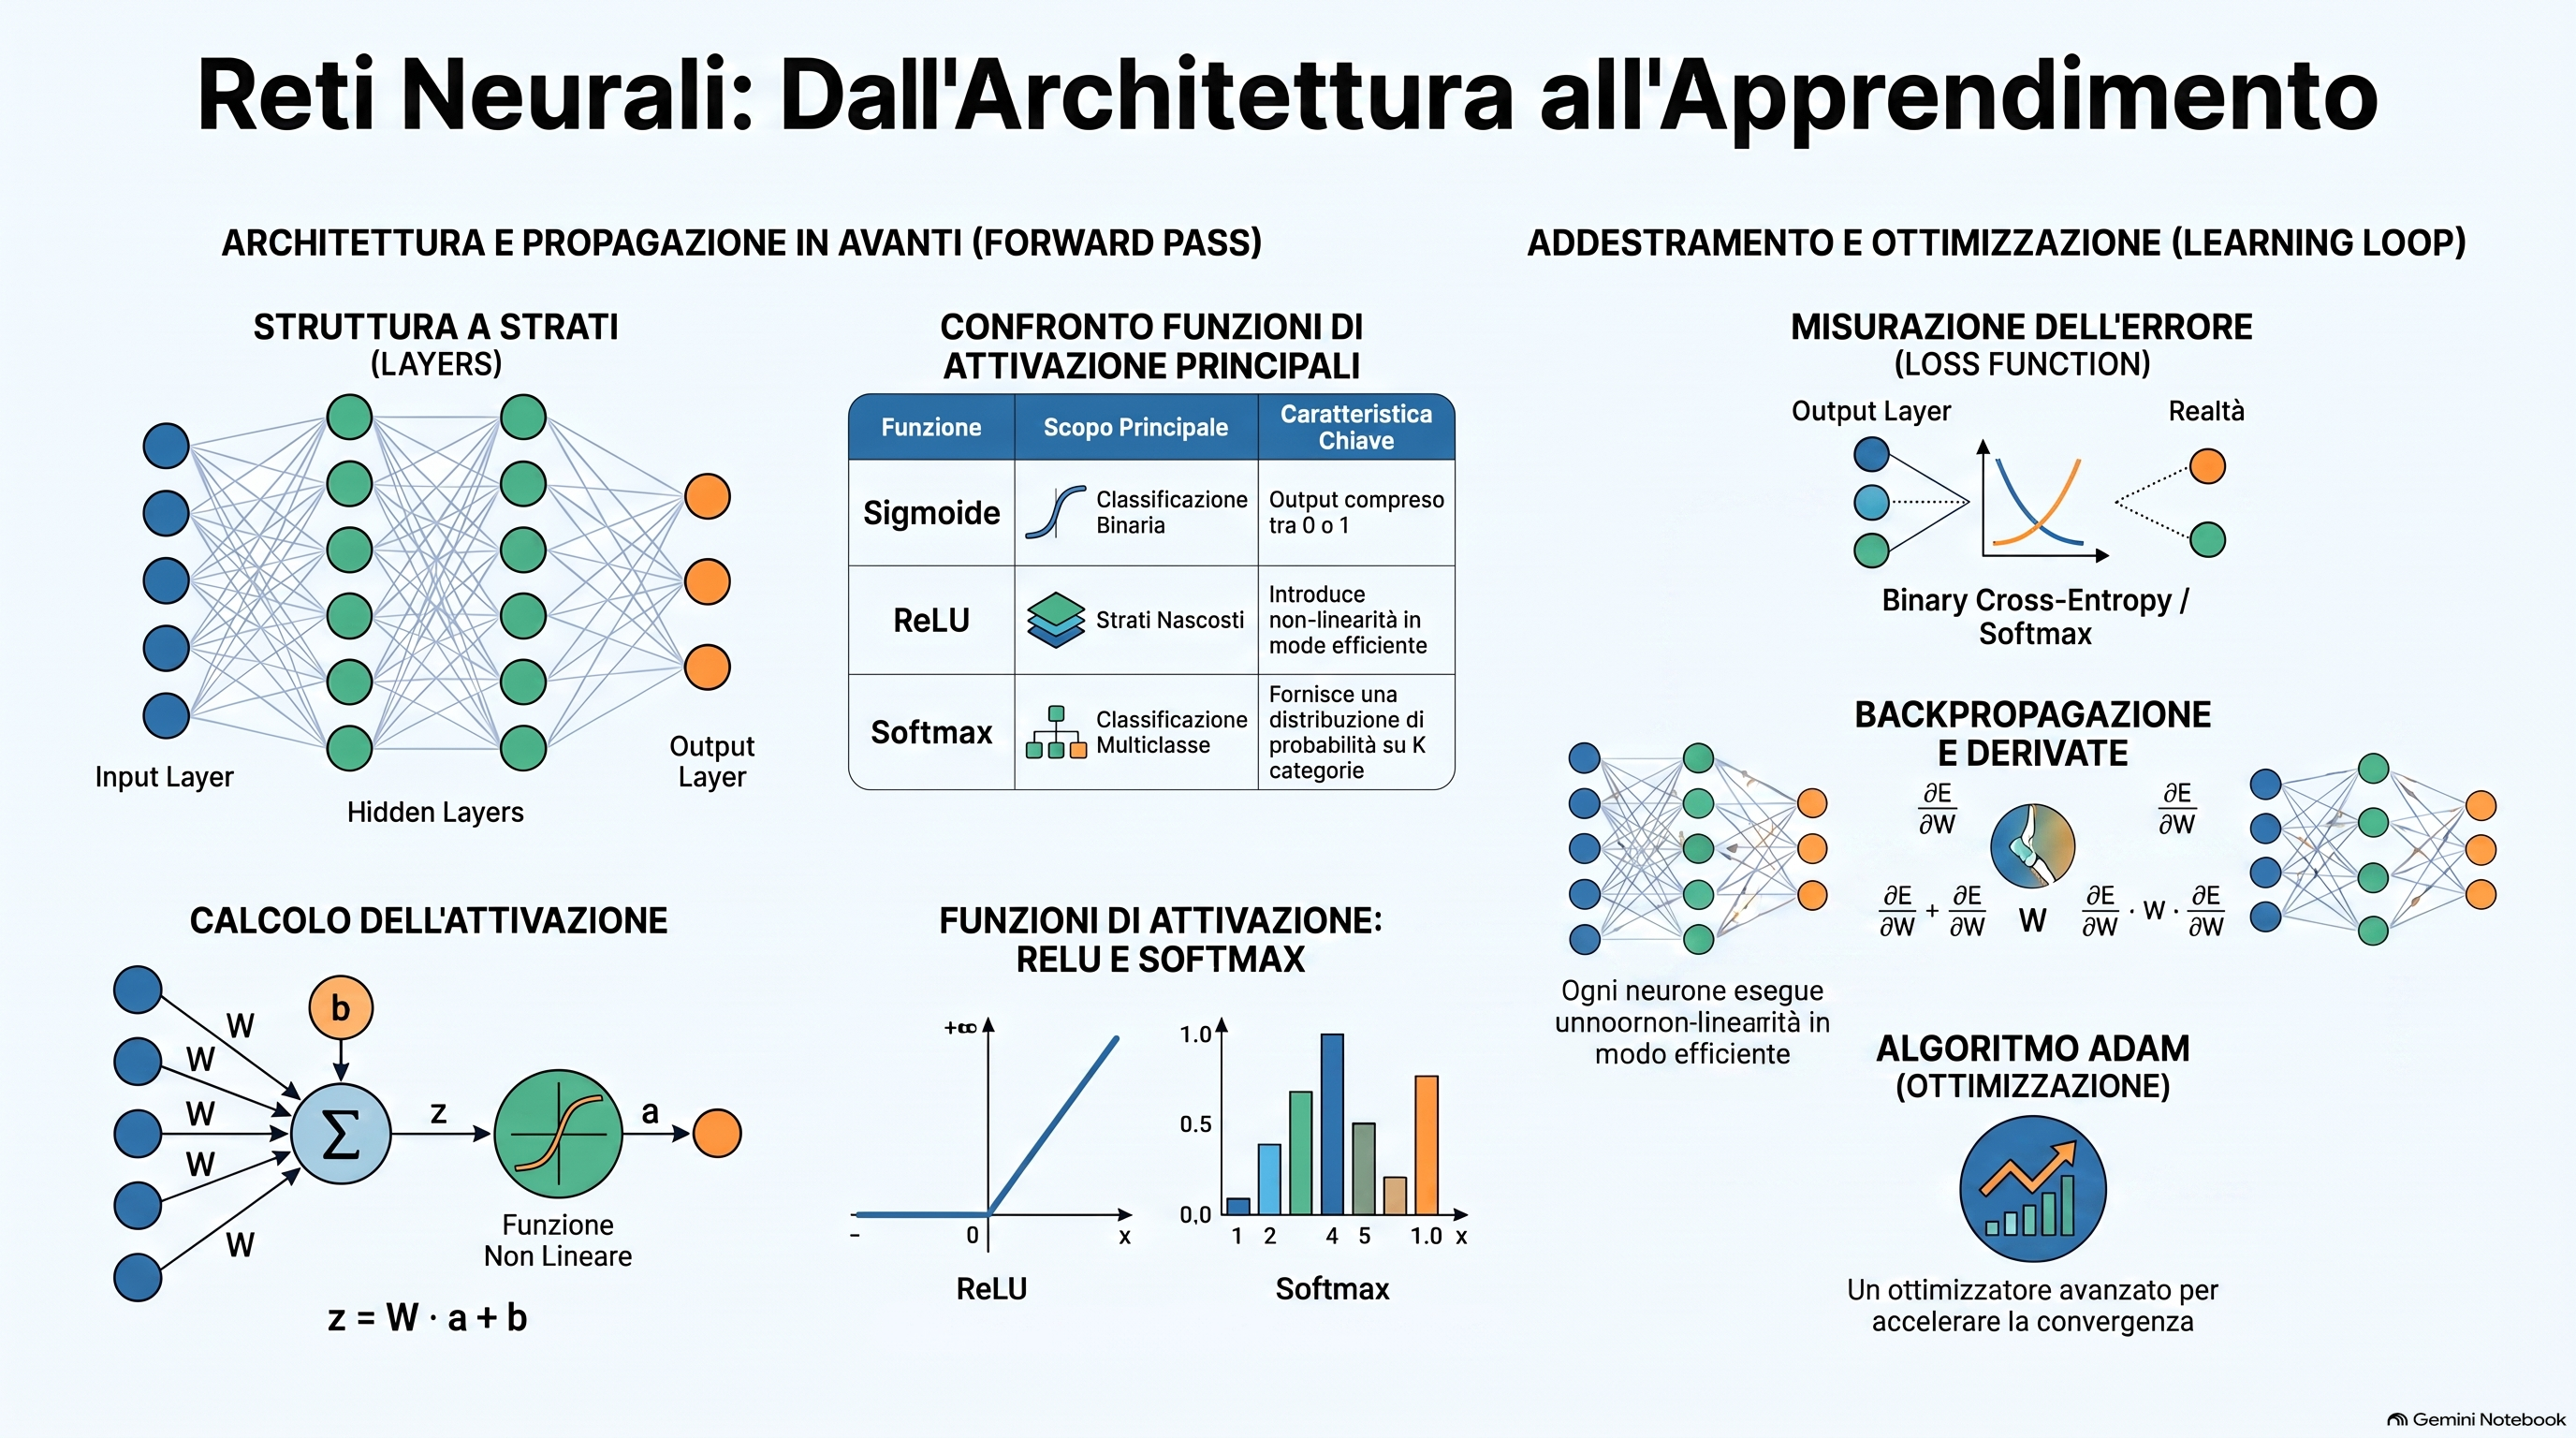
Ogni neurone \(j\) appartenente al livello \(l\) calcola una combinazione lineare pesata delle attivazioni provenienti dal livello precedente \(\mathbf{a}^{[l-1]}\), aggiunge il proprio bias scalare \(b_j^{[l]}\) e applica una funzione di attivazione non lineare \(g\):
\[z_j^{[l]} = \mathbf{w}_j^{[l]} \cdot \mathbf{a}^{[l-1]} + b_j^{[l]}\] \[a_j^{[l]} = g\left( z_j^{[l]} \right)\]
Formulazione Matriciale Vettorizzata
Invece di iterare sui singoli neuroni, l'intero strato \(l\) viene calcolato in una singola operazione matriciale ad altissima efficienza:
\[\mathbf{Z}^{[l]} = \mathbf{A}^{[l-1]} \mathbf{W}^{[l]} + \mathbf{b}^{[l]}\] \[\mathbf{A}^{[l]} = g\left( \mathbf{Z}^{[l]} \right)\]
Perché la Non-Linearità è Indispensabile: La Supremazia della ReLU
Cosa accadrebbe se impostassimo tutte le funzioni di attivazione come lineari (\(g(z) = z\))?
Matematicamente, una composizione di trasformazioni lineari è identica a una singola trasformazione lineare: \[\mathbf{A}^{[2]} = \mathbf{W}^{[2]} \left( \mathbf{W}^{[1]} \mathbf{x} + \mathbf{b}^{[1]} \right) + \mathbf{b}^{[2]} = \left( \mathbf{W}^{[2]} \mathbf{W}^{[1]} \right) \mathbf{x} + \left( \mathbf{W}^{[2]} \mathbf{b}^{[1]} + \mathbf{b}^{[2]} \right) = \mathbf{W}' \mathbf{x} + \mathbf{b}'\]
Una rete neurale profonda da \(50\) strati priva di attivazioni non lineari avrebbe la stessa identica potenza espressiva di una semplice regressione lineare.
ReLU: Rectified Linear Unit
La funzione ReLU è lo standard incontrastato dell'ingegneria del deep learning:
\[g(z) = \max(0, z)\]
\[\frac{d}{dz} g(z) = \begin{cases} 1 & \text{se } z > 0 \\ 0 & \text{se } z < 0 \end{cases}\]
- Vantaggio Computazionale: Richiede una semplice comparazione di soglia con zero a livello di istruzione CPU/GPU.
- Saturazione del Gradiente Evitata: Poiché la derivata per valori positivi è costantemente \(1\), la ReLU non soffre del fenomeno dell'evanescenza del gradiente (Vanishing Gradient), consentendo l'addestramento stabile di centinaia di layer.
Classificazione Multiclasse: Regressione Softmax e Stabilità Numerica
Quando le categorie target possibili sono \(K > 2\) disgiunte (es. classificazione automatica di 10 tipi di difetti ottici su laminati d'acciaio), lo strato di output adotta la funzione Softmax:
\[a_k = P(y = k \mid \mathbf{x}) = \frac{e^{z_k}}{\sum_{j=1}^{K} e^{z_j}} \quad \text{per } k = 1, \dots, K\]
I valori continui \(z_k\) sono chiamati Logits. La funzione Softmax garantisce che la somma di tutte le attivazioni dello strato finale sia rigorosamente pari a \(1\).
La Stabilità Numerica: from_logits=True
Nei calcolatori elettronici a precisione finita (32-bit Float), calcolare prima \(a_k\) ed eseguire successivamente \(-\log(a_k)\) genera gravi instabilità numeriche:
- Se \(z_k = 1000\), \(e^{1000}\) produce Overflow istantaneo (\(\infty\)).
- Se \(a_k \to 0\), \(\log(0)\) produce Underflow (\(-\infty\)).
Impostando from_logits=True nella funzione di perdita, il framework calcola la loss di Cross-Entropy combinando algebricamente l'esponenziale con il logaritmo (Log-Sum-Exp trick):
\[\text{Loss} = -z_y + \log\left(\sum_{j=1}^K e^{z_j}\right) = -z_y + \max(\mathbf{z}) + \log\left(\sum_{j=1}^K e^{z_j - \max(\mathbf{z})}\right)\]
Backpropagation e l'Ottimizzatore Adam
L'algoritmo di Backpropagation permette di calcolare le derivate parziali \(\frac{\partial J}{\partial \mathbf{W}^{[l]}}\) e \(\frac{\partial J}{\partial \mathbf{b}^{[l]}}\) trattando la rete come un grafo di calcolo orientato e applicando a ritroso la regola della catena (Chain Rule):
\[\frac{\partial J}{\partial \mathbf{W}^{[l]}} = \frac{\partial J}{\partial \mathbf{Z}^{[l]}} \cdot \frac{\partial \mathbf{Z}^{[l]}}{\partial \mathbf{W}^{[l]}} = \left( \frac{\partial J}{\partial \mathbf{A}^{[l]}} \odot g'\left(\mathbf{Z}^{[l]}\right) \right) \left(\mathbf{A}^{[l-1]}\right)^T\]
Ottimizzatore Adam (Adaptive Moment Estimation)
Mentre la discesa del gradiente classica (SGD) applica un learning rate costante identico per tutti i pesi, Adam stima individualmente i momenti del primo e secondo ordine dei gradienti storici:
\[m_t = \beta_1 m_{t-1} + (1 - \beta_1) g_t \quad \text{(Media mobile esponenziale dei gradienti)}\] \[v_t = \beta_2 v_{t-1} + (1 - \beta_2) g_t^2 \quad \text{(Secondo momento non centrato dei gradienti)}\] \[\hat{m}_t = \frac{m_t}{1 - \beta_1^t}, \quad \hat{v}_t = \frac{v_t}{1 - \beta_2^t}\] \[w_t := w_{t-1} - \frac{\alpha}{\sqrt{\hat{v}_t} + \epsilon} \hat{m}_t\]
Laboratorio Pratico: Forward Pass in NumPy e Keras Completo
import numpy as np
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense

# ==========================================
# 1. FORWARD PASS FROM SCRATCH IN NUMPY
# ==========================================
def relu(z):
    return np.maximum(0, z)

def softmax_stable(z):
    exp_z = np.exp(z - np.max(z, axis=-1, keepdims=True))
    return exp_z / np.sum(exp_z, axis=-1, keepdims=True)

def forward_pass_numpy(x, W1, b1, W2, b2, W3, b3):
    # Layer 1 (Dense + ReLU)
    z1 = np.dot(x, W1) + b1
    a1 = relu(z1)

    # Layer 2 (Dense + ReLU)
    z2 = np.dot(a1, W2) + b2
    a2 = relu(z2)

    # Layer 3 (Output Logits)
    z3 = np.dot(a2, W3) + b3
    a3 = softmax_stable(z3)
    return a3

# ==========================================
# 2. ARCHITETTURA INDUSTRIALE IN TENSORFLOW
# ==========================================
# Configurazione modello a 3 strati con from_logits=True
model = Sequential([
    Dense(units=64, activation='relu', name='layer_hidden_1', input_shape=(16,)),
    Dense(units=32, activation='relu', name='layer_hidden_2'),
    Dense(units=5, activation='linear', name='logits_output') # 5 classi di difetti
])

# Compilazione con ottimizzatore Adam e Loss numericamente stabile
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=0.001),
    loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
    metrics=['accuracy']
)

# Generazione dati sintetici per verifica
X_train = np.random.randn(500, 16).astype(np.float32)
y_train = np.random.randint(0, 5, size=(500,)).astype(np.int32)

print("Addestramento della rete neurale in corso...")
history = model.fit(X_train, y_train, epochs=10, batch_size=32, verbose=0)
print(f"Loss finale: {history.history['loss'][-1]:.4f} | Accuracy: {history.history['accuracy'][-1]*100:.2f}%")
Conclusioni
Le reti neurali dense e il calcolo automatico dei gradienti costituiscono una base importante per le architetture avanzate. La lezione successiva sposta l'attenzione sulla diagnostica dei modelli, sulle curve di apprendimento per analizzare bias e varianza e sugli alberi decisionali con XGBoost.
Verifica se il concetto è passato
Cosa accadrebbe impilando molti layer senza alcuna funzione di attivazione non lineare?
Controlla la risposta
Le trasformazioni lineari collasserebbero in un'unica trasformazione lineare: la profondità non aggiungerebbe capacità espressiva.
Domande frequenti
Perché una rete neurale non può fare a meno di funzioni di attivazione non lineari?
Poiché una combinazione lineare di funzioni lineari è sempre equivalente a una singola trasformazione lineare (W2 * (W1 * x + b1) + b2 = W' * x + b'). Senza attivazioni non lineari, una rete con centinaia di strati avrebbe lo stesso potere espressivo di una modesta regressione lineare.
Qual è il vantaggio della funzione ReLU rispetto alla Sigmoide negli strati nascosti?
La ReLU (max(0, z)) è estremamente veloce da calcolare e la sua derivata è costantemente 1 per z > 0, eliminando il problema del gradiente evanescente (Vanishing Gradient) che invece affligge la sigmoide per valori elevati di input.
Cosa si intende per stabilità numerica con 'from_logits=True' in TensorFlow/PyTorch?
Nei calcolatori a precisione finita a 32 o 64 bit, calcolare esplicitamente l'esponenziale di numeri grandi nella softmax causa overflow (infinito), mentre numeri molto negativi causano underflow (zero nel logaritmo). Impostando from_logits=True, il framework fonde algebricamente la loss con la softmax, evitando cancellazioni numeriche catastrofiche.
Come funziona l'ottimizzatore Adam rispetto alla discesa del gradiente stocastica standard?
Adam usa medie mobili dei gradienti e dei loro quadrati, con correzione del bias iniziale. Il secondo accumulatore stima un secondo momento non centrato, non la varianza. Adatta la scala degli aggiornamenti per parametro; velocità e qualità finale dipendono dal problema.
Cosa differenzia la classificazione multiclasse dalla classificazione multi-label?
Nella classificazione multiclasse (Softmax) ogni campione appartiene a una e una sola classe mutuamente esclusiva tra K opzioni (somma probabilità = 1). Nella classificazione multi-label (Sigmoidi indipendenti per ogni output) un campione può appartenere simultaneamente a più classi contemporaneamente.
Fonti e approfondimenti
Continua da qui

Architettura Transformer e Meccanismo di Attenzione: Guida Completa agli LLM
Come funzionano i Transformer: limiti di RNN/LSTM, Positional Encoding, Scaled Dot-Product Attention, Multi-Head Attention ed Encoder-Decoder.

Mappa del Machine Learning: guida completa dai fondamenti alle architetture moderne
Guida esaustiva al Machine Learning: definizioni formali, tassonomia completa, paradigmi di apprendimento e workflow operativo end-to-end.

Reinforcement Learning: Dai Processi Decisionali di Markov a Deep Q-Networks (DQN)
Guida completa all'apprendimento per rinforzo: formalismo MDP, derivazione dell'Equazione di Bellman, policy epsilon-greedy e Deep Q-Learning.