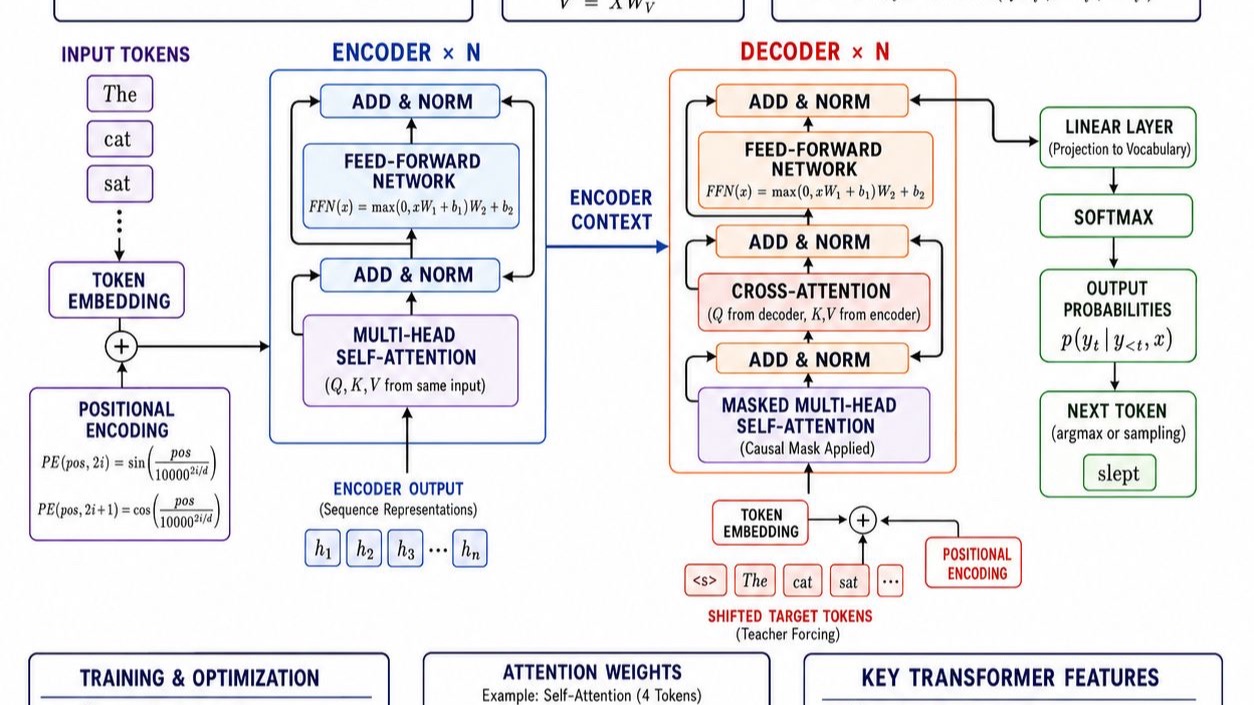
Architettura Transformer e Meccanismo di Attenzione: Guida Completa agli LLM
Come funzionano i Transformer: limiti di RNN/LSTM, Positional Encoding, Scaled Dot-Product Attention, Multi-Head Attention ed Encoder-Decoder.
LeggiGuide, analisi e storie Able2Code su LLM: 2 articoli con spiegazioni tecniche e difese pratiche.
Come funzionano i Transformer: limiti di RNN/LSTM, Positional Encoding, Scaled Dot-Product Attention, Multi-Head Attention ed Encoder-Decoder.
Leggi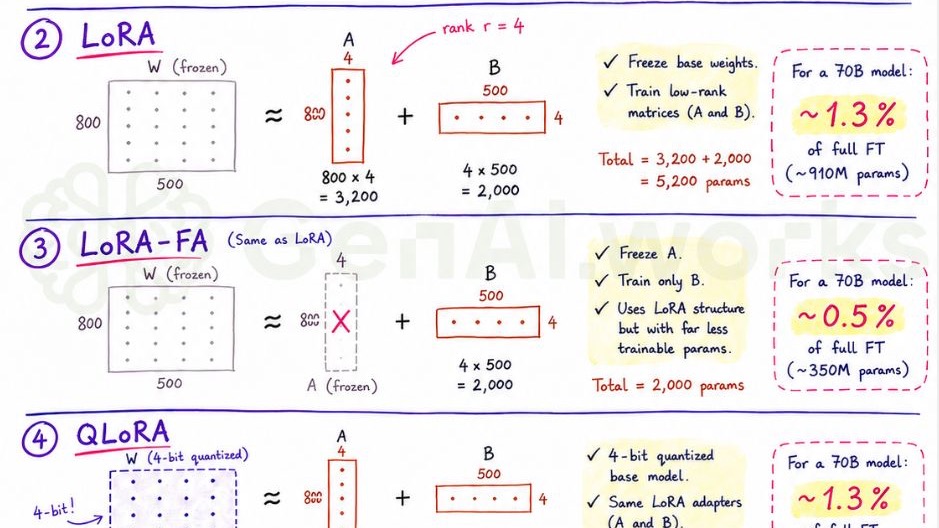
Come adattare un LLM con LoRA e QLoRA: parametri addestrabili, quantizzazione, memoria reale e configurazione PEFT senza promesse magiche.
Leggi